MariaDB Galera 10.6에서 11.4로 무중단 롤링 업그레이드

지원이 끝난 MariaDB 10.6 Galera 3노드를 10.6.28 → 10.11.19 → 11.4.13, 세 번의 롤링으로 올렸다. 서비스는 멈추지 않았고, 쓰기 연결이 차수마다 두 번 잠깐 끊긴 것 말고는 DB 오류가 한 건도 없었다.

운영 중인 MariaDB Galera 클러스터 세 대를 10.6 에서 11.4 로 올렸다. 2026-10-01 에 시작해 10-06 에 끝났고, 세 번 모두 업무 시간에 서비스를 켜 둔 채로 했다. 이 글은 그 과정과, 미리 리허설을 돌려 보지 않았다면 운영에서 처음 만났을 함정들을 정리한 것이다. 같은 일을 앞둔 사람이 순서대로 따라 할 수 있게 썼다.

1. 왜 올렸나

  • 10.6 은 커뮤니티 지원이 2026-07-06 에 끝났다. 마지막 판 10.6.28(2026-08-13) 의 릴리스 노트에는 “This is the final release in the MariaDB 10.6 series.” 라고 적혀 있다
  • 그런데 우분투 22.04 패키지는 10.6.23 에 머물러 있었다. jammy-updates 의 최신이 10.6.23 이고, 10.6.28 에 들어간 보안 수정(Galera 쪽 MDEV-40027·MDEV-40056 — SUPER 권한 사용자가 셸 명령을 실행할 수 있던 문제 둘 포함)을 받을 길이 없었다
  • 보안 인증 심사의 패치 관리 항목 에서 지적받을 수 있는 상태였다
  • 새 하드웨어는 없었다. 임시 노드를 붙여 새 클러스터로 넘기는 안은 접고, 지금 세 노드를 한 대씩 올리기로 했다
  • 목표를 11.4 로 잡은 이유: 10.11 의 지원은 2028-02-16 에, 11.4 는 2029-05-29 에 끝난다. 11.4 는 우분투 22.04(jammy)·24.04(noble) 둘 다 공식 패키지가 있어 다음 OS 전환도 수월하다

2. 환경
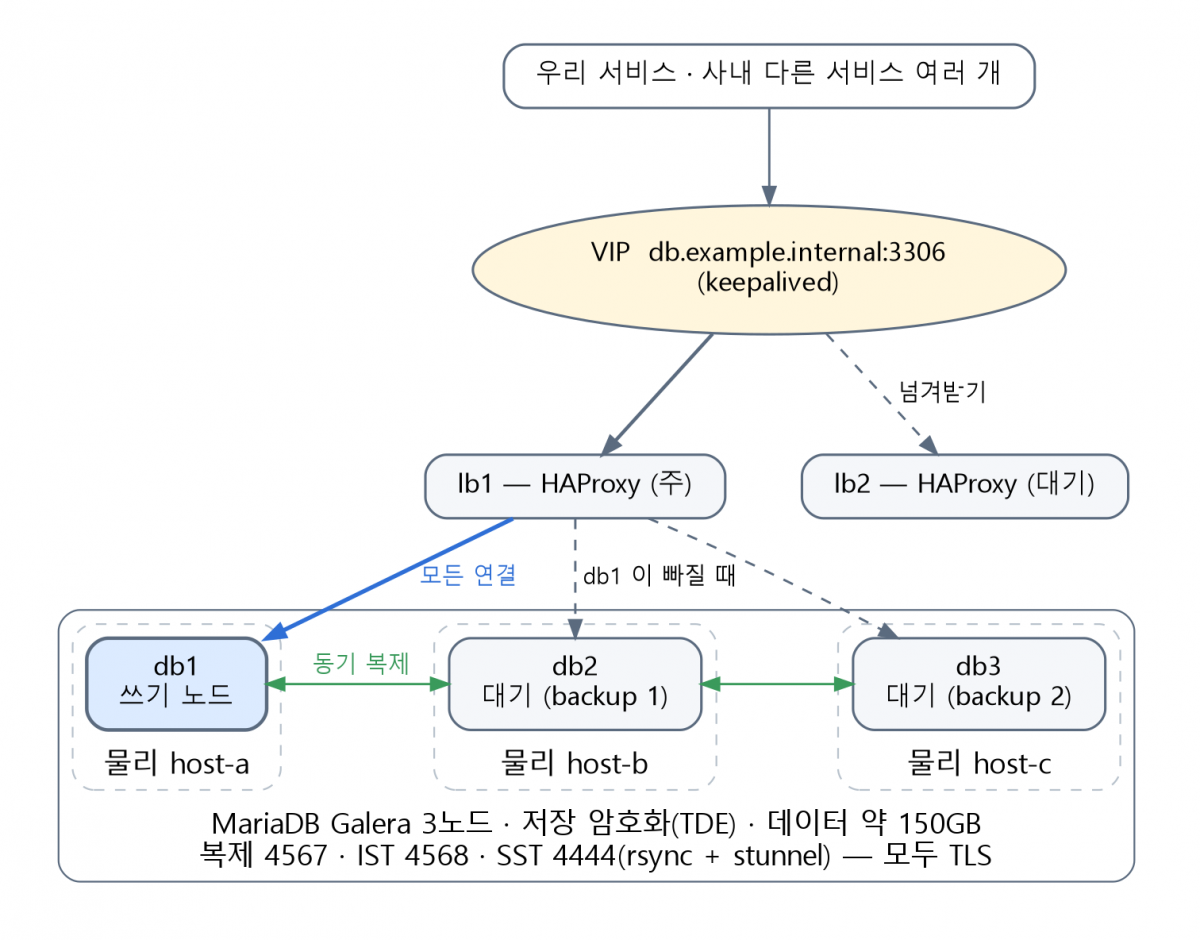
클러스터 구성 — 앞단 로드밸런서 두 대와 Galera 세 노드

이 구성은 예전 글 HAProxy + Galera Cluster (MariaDB) 1/2, 2/2 에서 다뤘다. 그 뒤로 바뀐 것까지 합치면 지금은 이렇다.

  • 노드: 우분투 22.04 VM 세 대 (db1·db2·db3). 노드마다 다른 물리 호스트에 있다. 데이터 디렉터리 /db 는 OS 와 다른 디스크이고 데이터는 약 150GB 다
  • 앞단: HAProxy 두 대(lb1·lb2) 와 keepalived VIP. 모든 연결을 db1 하나로 보내고 db2·db3 는 backup 으로 둔다. 쓰기 노드가 하나라 Galera 의 인증 충돌을 걱정할 일이 없다
  • 상태 검사: 외부 스크립트로 HAProxy 노드를 검사한다. 노드가 Synced(wsrep_local_state=4) 일 때만 UP 이다 — 업그레이드 중인 노드는 저절로 빠진다
  • 암호화: 저장 암호화(TDE, file_key_management) 로 우리 서비스 테이블을 암호화했고, 3306 · Galera 복제(4567) · IST(4568) · SST(4444, rsync + stunnel) 를 모두 TLS 로 감쌌다
  • 쓰기량: 시간당 0.5GB 안팎, gcache 는 2GB 다
  • 함께 쓰는 곳: 우리 서비스 말고도 사내 다른 서비스 여러 개가 같은 클러스터를 쓴다. 그래서 끊김을 줄이는 것이 가장 중요했다

3. 한 번에 못 간다 — 경로
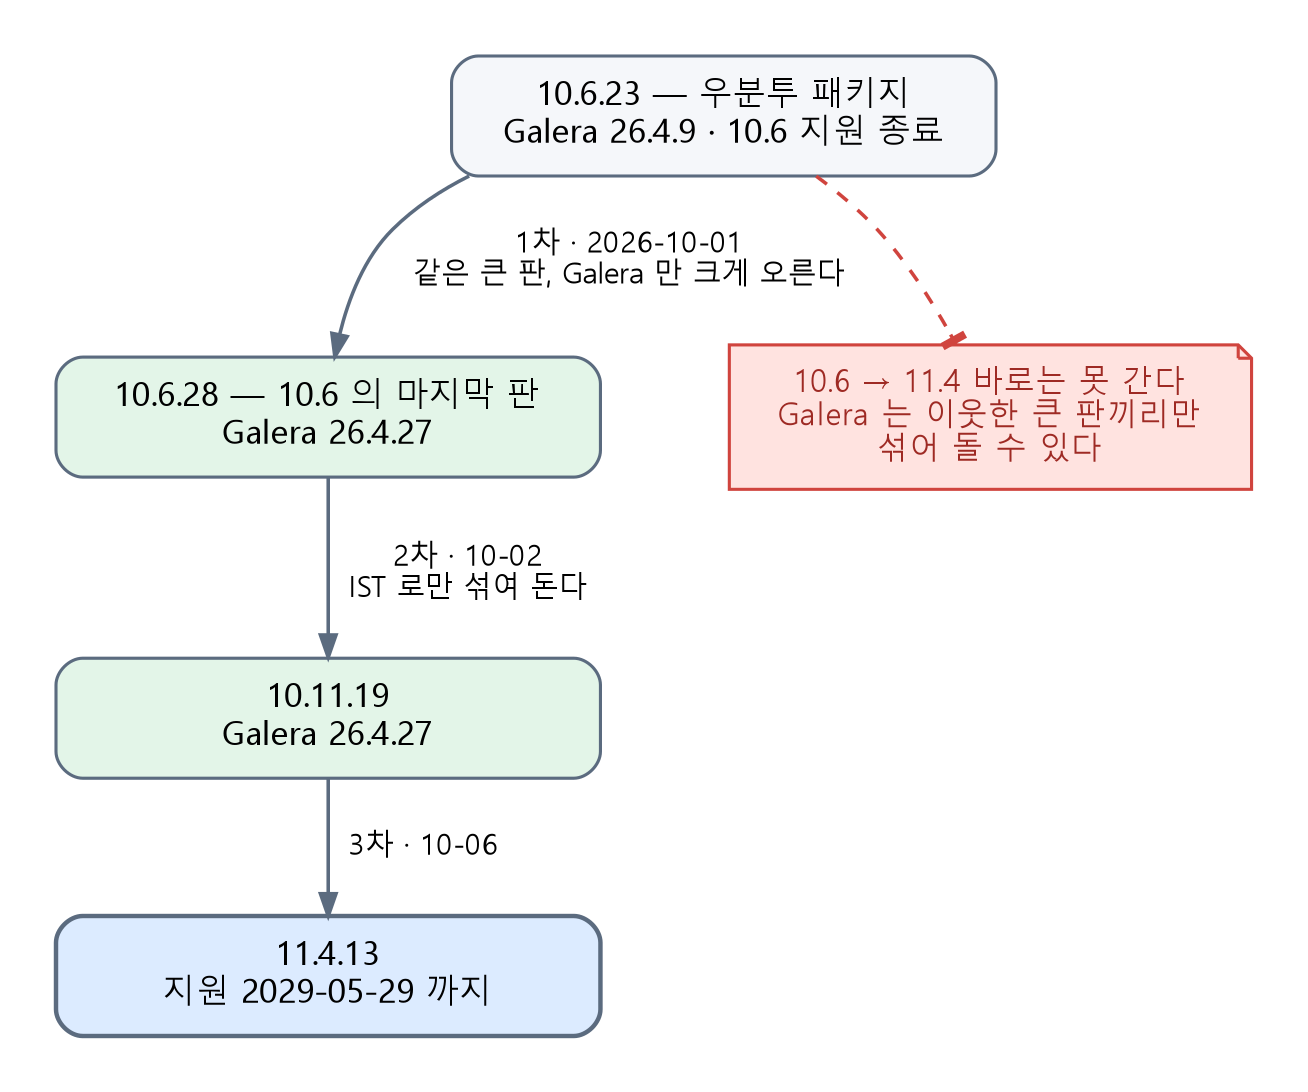
업그레이드 경로 — 10.6.23 에서 11.4.13 까지 세 번
차수 판 Galera 패키지 이름
1차 10.6.23(우분투) → 10.6.28 26.4.9 → 26.4.27 같다 (mariadb-server-10.6 …)
2차 10.6.28 → 10.11.19 그대로 바뀐다 — -10.6 이 붙은 이름이 지워지고 판 없는 이름이 들어온다
3차 10.11.19 → 11.4.13 그대로 같다 + -compat 패키지 둘이 더 들어온다
  • 10.6 에서 11.4 로 바로 가는 롤링은 없다. Galera 는 이웃한 큰 판끼리만 섞어 돌 수 있다
  • 10.6 → 10.11 은 IST 로만 롤링된다. 공식 문서의 표현은 “rolling upgrade with IST is supported, but rolling upgrade with SST does not work for this jump” 다
  • 그래서 10.6 의 최신(10.6.28) 을 먼저 거친다. 문서: “If you are upgrading from the most recent MariaDB 10.6 release to MariaDB 10.11, then the versions will be compatible.”
  • 1차에서 Galera 가 26.4.9 → 26.4.27 로 크게 오른다. 사이에 GCS 프로토콜이 여러 번 바뀌었다. 섞여 있는 동안은 옛 프로토콜로 돌다가 세 노드가 다 오르면 새 프로토콜로 넘어가고, 그때부터는 한 노드만 되돌릴 수 없다 (“prevents downgrades of individual nodes in the cluster as soon as all nodes have been updated”)
  • 패키지 출처가 바뀐다. 우분투 저장소에서 MariaDB 공식 저장소로 옮긴다. 판은 끝자리까지 고정한다 — 리허설한 판과 운영에 들어가는 판이 같아야 한다

4. IST 와 SST, 그리고 gcache 여유
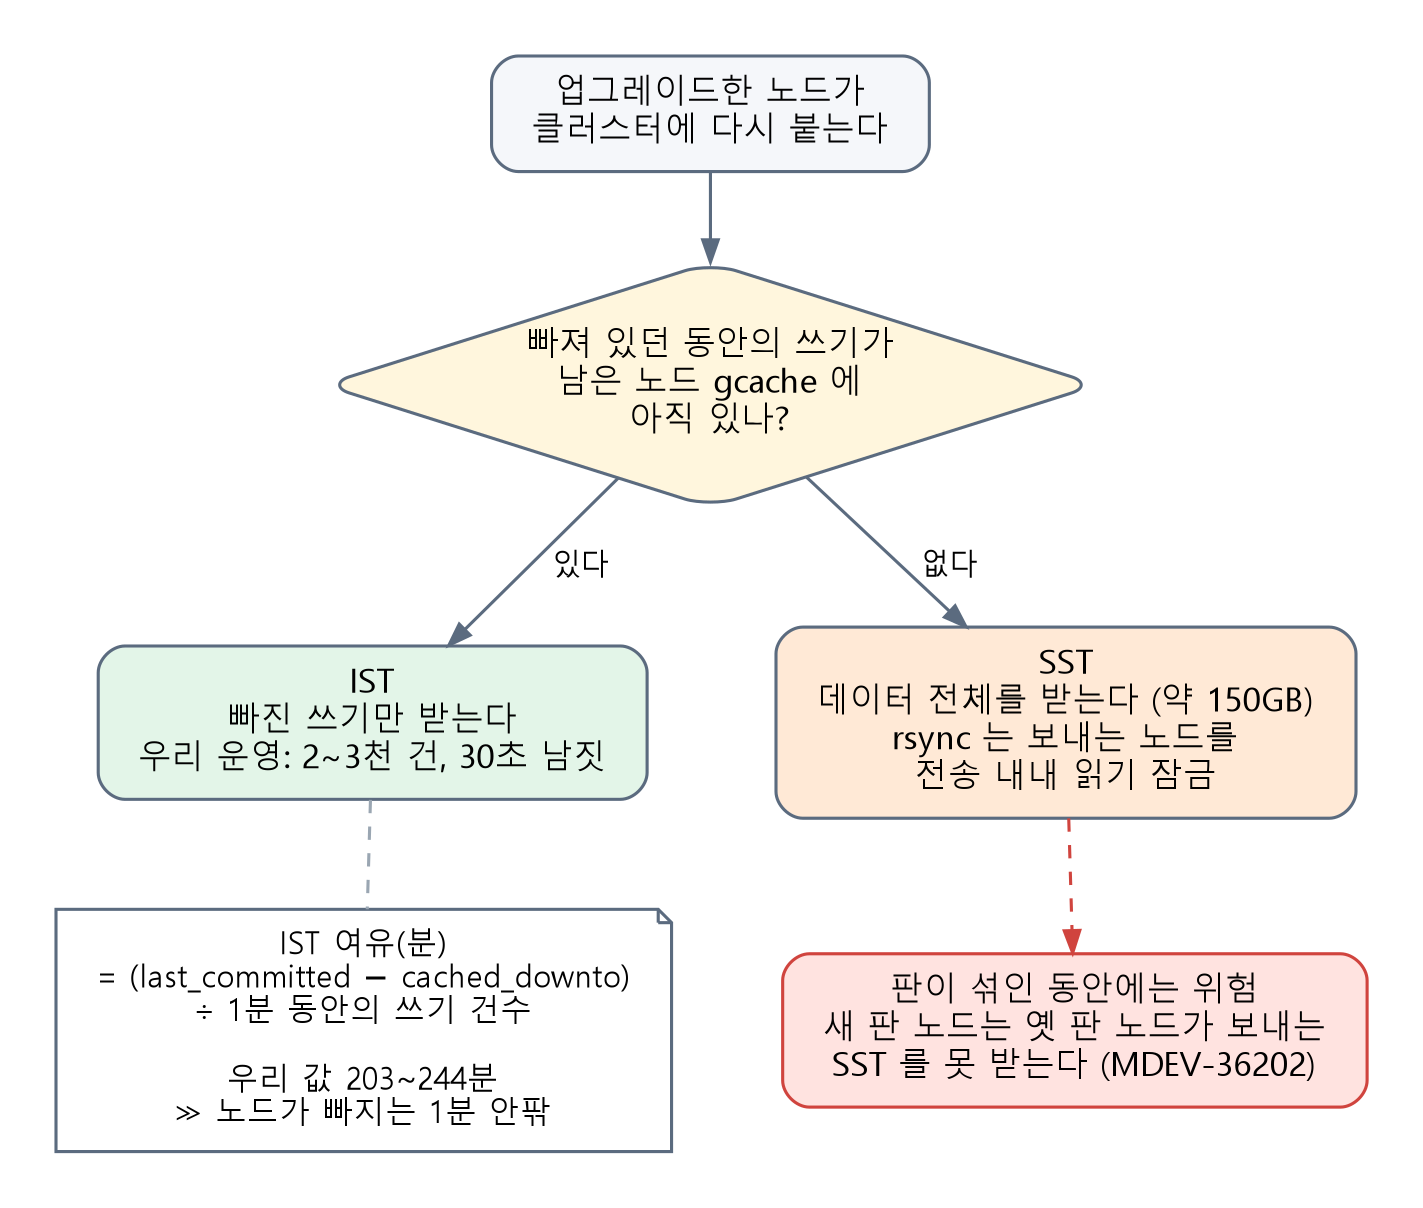
업그레이드한 노드가 다시 붙을 때 — IST 와 SST

노드 하나를 멈췄다가 새 판으로 다시 켜면, 그 노드는 빠져 있던 동안의 쓰기를 따라잡아야 한다.

  • IST: 빠진 쓰기가 남은 노드의 gcache 에 아직 있으면 그것만 받는다. 우리 운영에서는 2~3천 건, 30초 남짓이었다
  • SST: gcache 를 넘었으면 데이터 전체(약 150GB) 를 받는다. rsync SST 는 보내는 노드(donor) 를 전송 내내 읽기 잠금으로 묶는다
  • 판이 섞인 동안의 SST 는 위험하다. 새 판 joiner 는 옛 판 donor 가 보내는 SST 를 받지 못한다 (MDEV-36202, InnoDB: Upgrade after a crash is not supported). 리허설에서 일부러 gcache 를 넘겨 보니 그 노드만 죽고 남은 두 노드는 멀쩡했다. 그 노드를 옛 판으로 내려 켜면 전체 SST 로 다시 붙었다

그래서 노드를 멈추기 전에 IST 여유를 잰다. 노드마다 60초 간격으로 두 번 읽는다.

SELECT VARIABLE_NAME, VARIABLE_VALUE
  FROM information_schema.GLOBAL_STATUS
 WHERE VARIABLE_NAME IN ('WSREP_LAST_COMMITTED', 'WSREP_LOCAL_CACHED_DOWNTO');
여유(분) = (last_committed − cached_downto) ÷ 1분 동안 늘어난 last_committed

우리 값은 세 번 모두 203~244분이었고, 노드가 빠져 있는 시간은 1분 안팎이었다. 여유가 1시간 미만이면 미루기로 정해 두었다.

donor 도 정해 둔다. 60-galera.cnf 에 wsrep_sst_donor 한 줄을 넣는다.

  • 첫 노드 db3 는 쓰기 노드가 아닌 db2 에서 받는다 — "node2,". rsync SST 가 donor 를 잠그기 때문이다
  • db2·db1 은 이미 올라간 db3 에서 받는다 — "node3,". IST 가 안 돼 SST 로 넘어가도 같은 판끼리라 받을 수 있다
  • 끝의 쉼표는 “지정한 노드가 못 주면 다른 노드도 된다” 는 뜻이다

단, 큰 판이 섞여 있는 동안(특히 10.6 → 10.11)에는 끝 쉼표가 위험하다. 지정한 노드가 못 주면 옛 판 노드(쓰기 노드일 수도 있다)에서 SST 를 받으려 하는데, 새 판 joiner 는 그것을 받지 못하고(MDEV-36202) rsync SST 는 그동안 donor 를 잠근다. 섞인 동안에는 쉼표를 빼 같은 판 donor 로 못 박는 편이 안전하다. 우리는 쉼표를 둔 채로 했고 세 차수 모두 IST 로 붙어 이 길을 타지 않았다.

하나 더 — MDEV-28233 부터는 SST 암호화를 설정해 두고 실제로 할 수 없으면 평문으로 보내지 않고 SST 를 멈춘다. MariaDB 패키지는 stunnel 을 의존성으로 끌어오지 않으니 미리 깔려 있는지 본다.

5. 도커 리허설에서 미리 본 함정

운영에서는 읽기만 하고, 같은 우분투 22.04 · 같은 패키지 · 같은 설정(TDE·TLS 포함) 으로 도커에 세 노드를 세워 세 차수를 끝까지 돌렸다. 무결성 검사는 10번 모두 합격했고, 끊김은 차수마다 정확히 두 번이었다. 다음은 리허설이 아니었으면 운영에서 처음 만났을 것들이다.

10.11 설치는 서버를 켜지 않는다

1차(10.6.28) 와 3차(11.4.13) 는 설치 스크립트가 MariaDB 를 켠다. 2차(10.11.19) 는 켜지 않는다. mariadb-server-10.6 이 지워질 때 그 postrm 이 유닛을 mask 하고, 새 패키지의 postinst 는 멈춰 둔 서버를 그대로 둔다. 그래서 설치 뒤에 꺼져 있으면 켠다.

systemctl is-active --quiet mariadb || { systemctl daemon-reload; systemctl start mariadb; }

mariadb-upgrade 는 노드마다 돌린다

mariadb-upgrade 는 세션에 SET SQL_LOG_BIN=0, WSREP_ON=OFF 를 건다. 다른 노드로 복제되지 않으니 노드마다 한 번씩 돌려야 한다. 리허설에서 쓰기를 멈추고 여섯 번 돌려 보니 세 노드의 wsrep_last_committed 가 그대로였다 — 옛 판 노드가 섞여 있어도 해가 없다.

/db 안에 백업 사본을 두면 안 된다

데이터 디렉터리가 그 디스크의 맨 위라, 거기 둔 디렉터리는 이름이 무엇이든 MariaDB 가 DB 로 본다. 리허설에서 /db/.db-bak 이 #mysql50#.db-bak 으로 보였다.

  • mariadb-upgrade 가 Incorrect database name '#mysql50#.db-bak' 으로 실패한다
  • rsync SST 가 그 사본까지 함께 보낸다 — SST 가 두 배가 되고 받는 쪽 디스크가 찬다

OS 디스크에는 150GB 를 둘 자리가 없었다. 그래서 백업은 하이퍼바이저의 VM 스냅샷 으로 했다 (8절).

CREATE_OPTIONS 의 표기가 바뀐다

10.6.23 은 `ENCRYPTED`=YES, 10.6.28 부터는 `ENCRYPTED`='YES' 다. “아직 암호화 안 된 테이블” 을 고르는 우리 스크립트가 NOT LIKE 로 옛 표기를 찾고 있어서, 10.6.28 에서는 이미 암호화된 테이블을 전부 “안 된 것” 으로 골랐다. 그대로 실행했다면 큰 테이블을 다시 ALTER 했을 것이다. 두 표기를 다 받게 고쳤다.

-- 암호화된 테이블
WHERE CREATE_OPTIONS RLIKE '`ENCRYPTED`=.?YES'

11.4 클라이언트는 서버 인증서를 기본으로 검증한다

3차 도중에는 먼저 올라간 노드의 11.4 클라이언트로 아직 10.11 인 노드에 붙을 일이 생긴다. 3차 앞에 세 노드에 클라이언트용 CA 설정을 한 줄 둔다.

# /etc/mysql/mariadb.conf.d/63-client-tls.cnf
[client-mariadb]
ssl-ca = <DB 전용 CA 파일>

패키지 파일 50-client.cnf 는 고치지 않는다. 고치면 다음 업그레이드에서 conffile 질문이 생긴다.

자동 업데이트가 MariaDB 를 고르지 않게

저장소를 MariaDB 공식 저장소로 바꾸면 unattended-upgrades 가 새 판을 끌어올 수 있다. Package-Blacklist 에 mariadb-·libmariadb·galera 를 넣고, needrestart 가 MariaDB 를 저절로 재시작하지 않게 막은 뒤 확인한다.

unattended-upgrade --dry-run -d 2>&1 | grep -iE 'blacklist|mariadb|galera'

그 밖에

  • 없어진 옵션은 기동을 막지 않는다. 10.11·11.4 모두 “was removed. It does nothing now” 경고만 낸다. 그래도 1차에서 네 줄(innodb_buffer_pool_instances·innodb_log_files_in_group·innodb_thread_concurrency·innodb-defragment) 을 지웠다
  • /db/lost+found 가 있으면 mariadb-upgrade 가 lost@002bfound 라는 빈 DB 를 만든다. 생겼으면 업그레이드 전에 치운다

6. 노드 한 대 절차
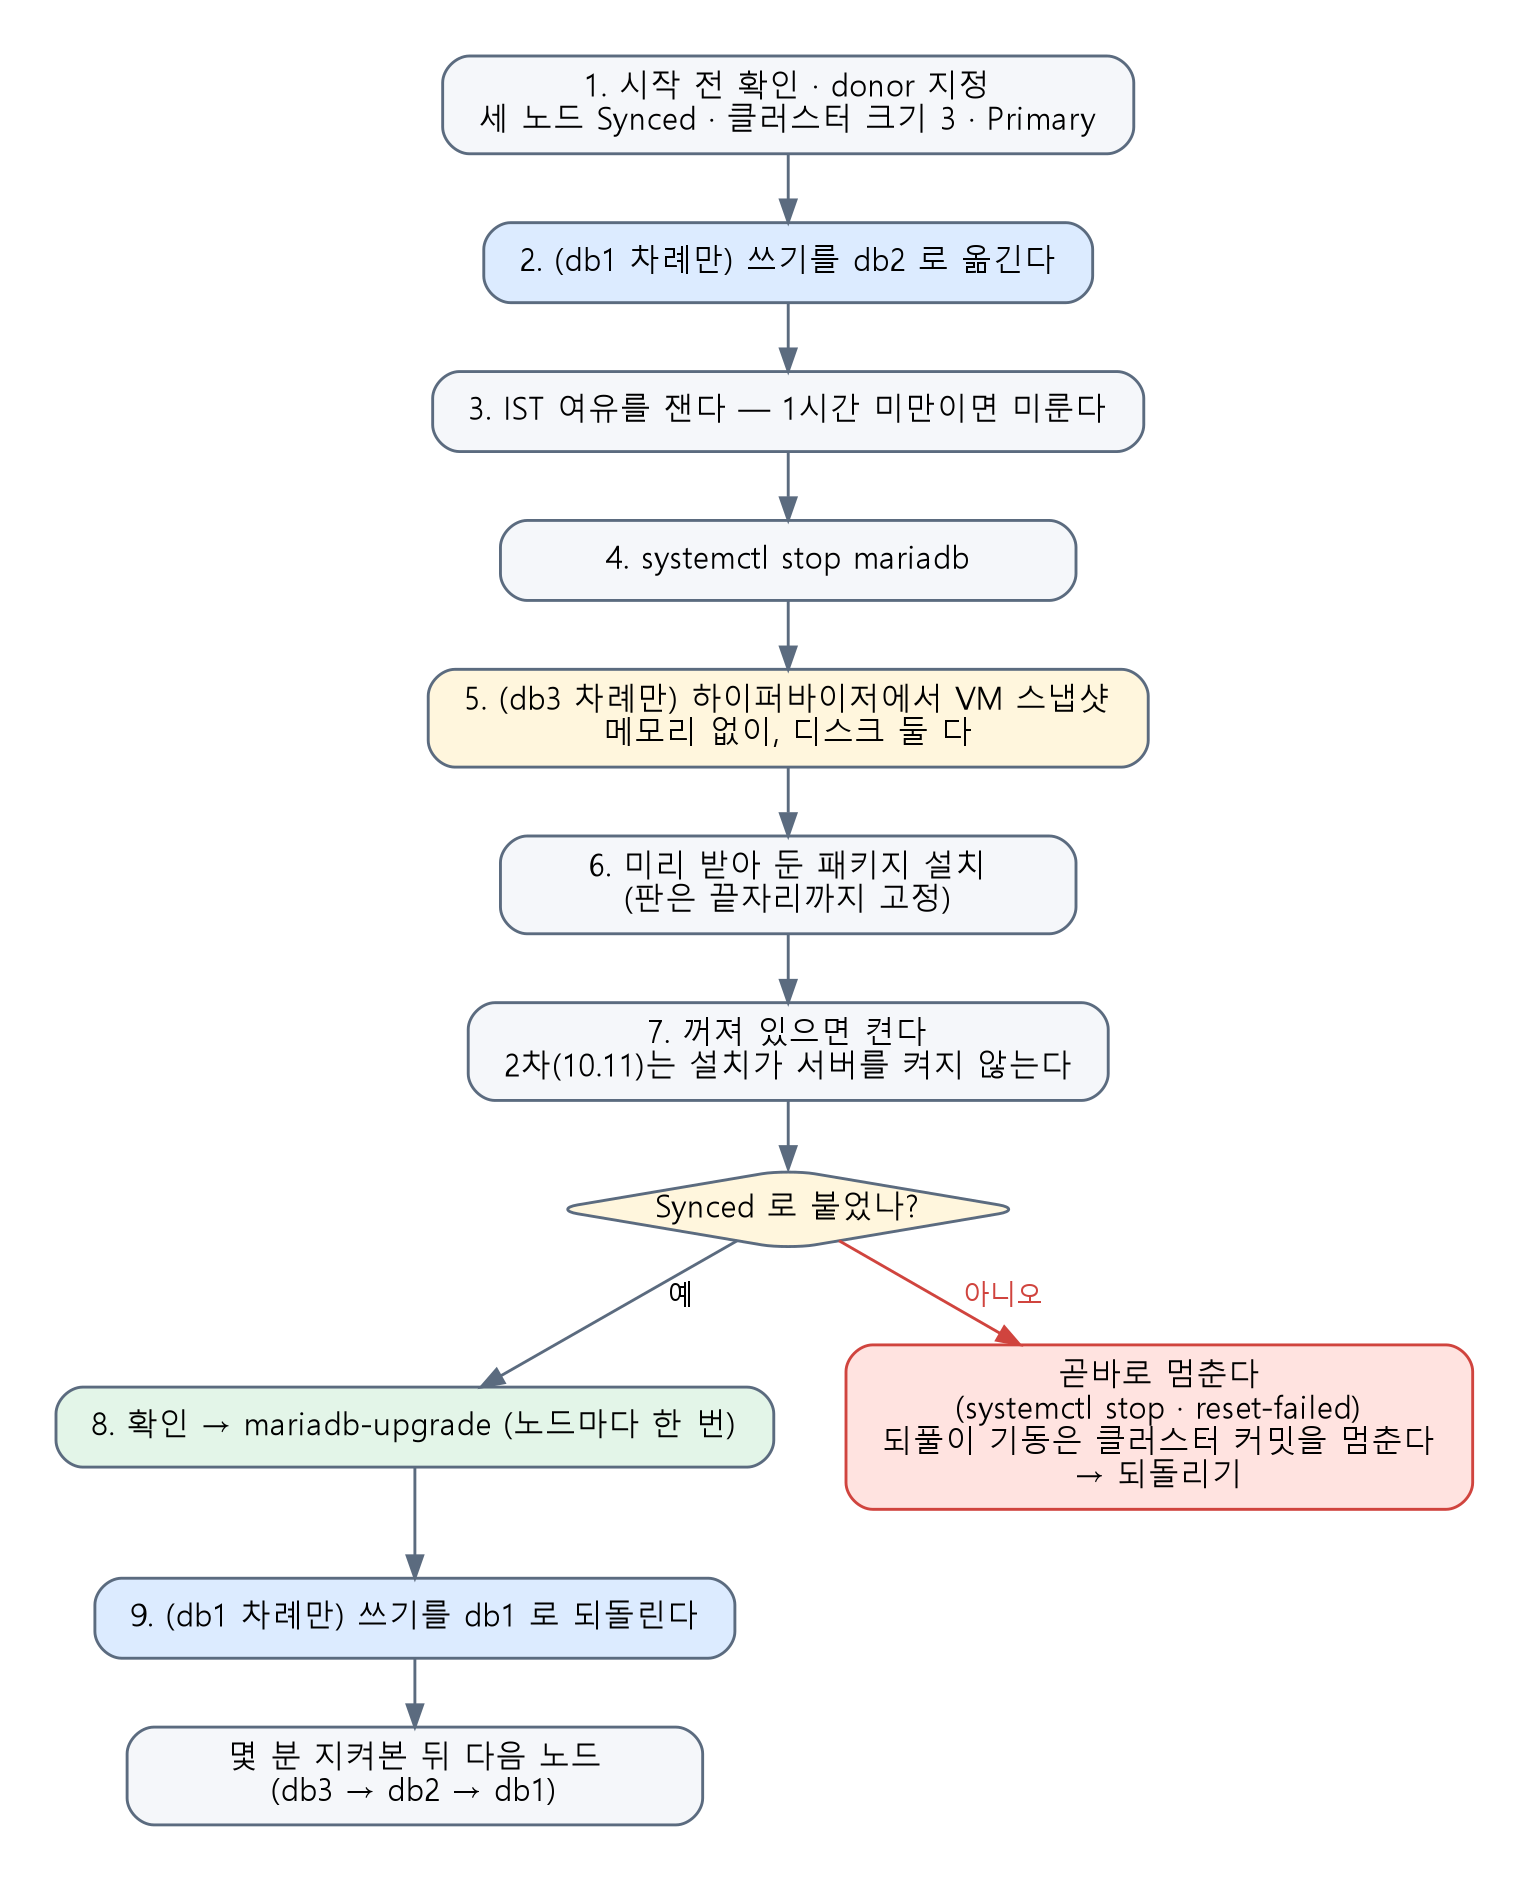
노드 한 대를 올리는 순서
노드 한 대를 올리는 순서

순서는 차수마다 db3 → db2 → db1 이다. 쓰기 노드 db1 을 맨 마지막에 둔다.

준비 (재시작 없음) — 차수 전날까지 세 노드에 해 둔다.

# /etc/mysql 을 통째로 백업 (키·인증서·설정이 다 여기 있다. 경로는 예시)
tar czf /var/backups/etc-mysql-$(date +%F).tgz -C / etc/mysql

# MariaDB 저장소 키링 — sha256 을 공식 값과 대조한다
install -d -m 0755 /etc/apt/keyrings
curl -fsSL -o /etc/apt/keyrings/mariadb-keyring.gpg https://supplychain.mariadb.com/mariadb-keyring-2025.gpg
sha256sum /etc/apt/keyrings/mariadb-keyring.gpg

# 이번 차수 판으로 저장소 파일을 직접 놓는다 — 판은 끝자리까지
cat > /etc/apt/sources.list.d/mariadb.sources <<'EOS'
Types: deb
URIs: https://dlm.mariadb.com/repo/mariadb-server/10.11.19/repo/ubuntu
Suites: jammy
Components: main
Architectures: amd64
Signed-By: /etc/apt/keyrings/mariadb-keyring.gpg
EOS
# 이 저장소가 우분투 패키지보다 앞서게 핀을 건다
printf 'Package: *\nPin: origin dlm.mariadb.com\nPin-Priority: 1000\n' > /etc/apt/preferences.d/mariadb-enterprise.pref
apt-get update
apt-get -d -y install mariadb-server mariadb-client mariadb-backup galera-4 libmariadb3 mysql-common   # 받아만 둔다

mariadb_repo_setup 스크립트는 수시로 바뀐다. 운영 날 받은 스크립트가 리허설 때와 다른 파일을 만들 수 있어서, 스크립트가 만드는 파일을 직접 놓았다. 키링 파일은 sha256 을 공식 값과 대조한다.

아래 명령은 노드·로드밸런서에서 root 로 친다.

노드 한 대

  1. 시작 전 확인 · 이 노드 차례의 wsrep_sst_donor 지정 (4절) — 세 노드 Synced, wsrep_cluster_size=3, Primary. 로드밸런서 두 대에서 db1~3 이 모두 UP
  2. (db1 차례만) 쓰기를 db2 로 — 7절
  3. IST 여유를 잰다 — 1시간 미만이면 미룬다
  4. 멈춘다 — systemctl stop mariadb. 남은 두 노드가 Primary·Synced 인지 본다
  5. (db3 차례만) VM 스냅샷 — 8절
  6. 설치

DEBIAN_FRONTEND=noninteractive NEEDRESTART_MODE=l apt-get install -y \
-o Dpkg::Options::=--force-confdef -o Dpkg::Options::=--force-confold \
mariadb-server mariadb-client mariadb-backup galera-4 libmariadb3 mysql-common

  1. 꺼져 있으면 켠다 — 2차만 해당 (5절)

systemctl is-active --quiet mariadb || { systemctl daemon-reload; systemctl start mariadb; }

  1. Synced 를 확인한 뒤 mariadb-upgrade

cd /tmp && sudo -u mysql mariadb-upgrade --user=mysql --skip-write-binlog

우분투 기본 설치는 root 가 unix_socket 이라 sudo mariadb-upgrade --skip-write-binlog 로 된다. 우리 노드는 root 로그인이 막혀 있어 설치 때 만들어지는 mysql@localhost(unix_socket) 로 돌렸다. cd /tmp 는 mysql 사용자가 지금 디렉터리(/root)를 못 읽어 나는 오류를 피하려는 것이다

  1. (db1 차례만) 쓰기를 db1 로 되돌린다
  2. 몇 분 지켜보고 다음 노드. 차수의 첫 노드 db3 는 30분 지켜봤다

붙지 못하면 곧바로 멈춘다. systemctl stop mariadb; systemctl reset-failed mariadb. 리허설에서 붙지 못한 노드를 그냥 두었더니 systemd 가 5분 동안 31번 다시 띄웠고, 붙으려 할 때마다 남은 두 노드가 그 노드를 넣었다 뺐다 하며 커밋을 세웠다 — 1초 넘게 걸린 쓰기가 41건, 10초 시간 초과가 5건이었다.

7. 쓰기 노드 옮기기
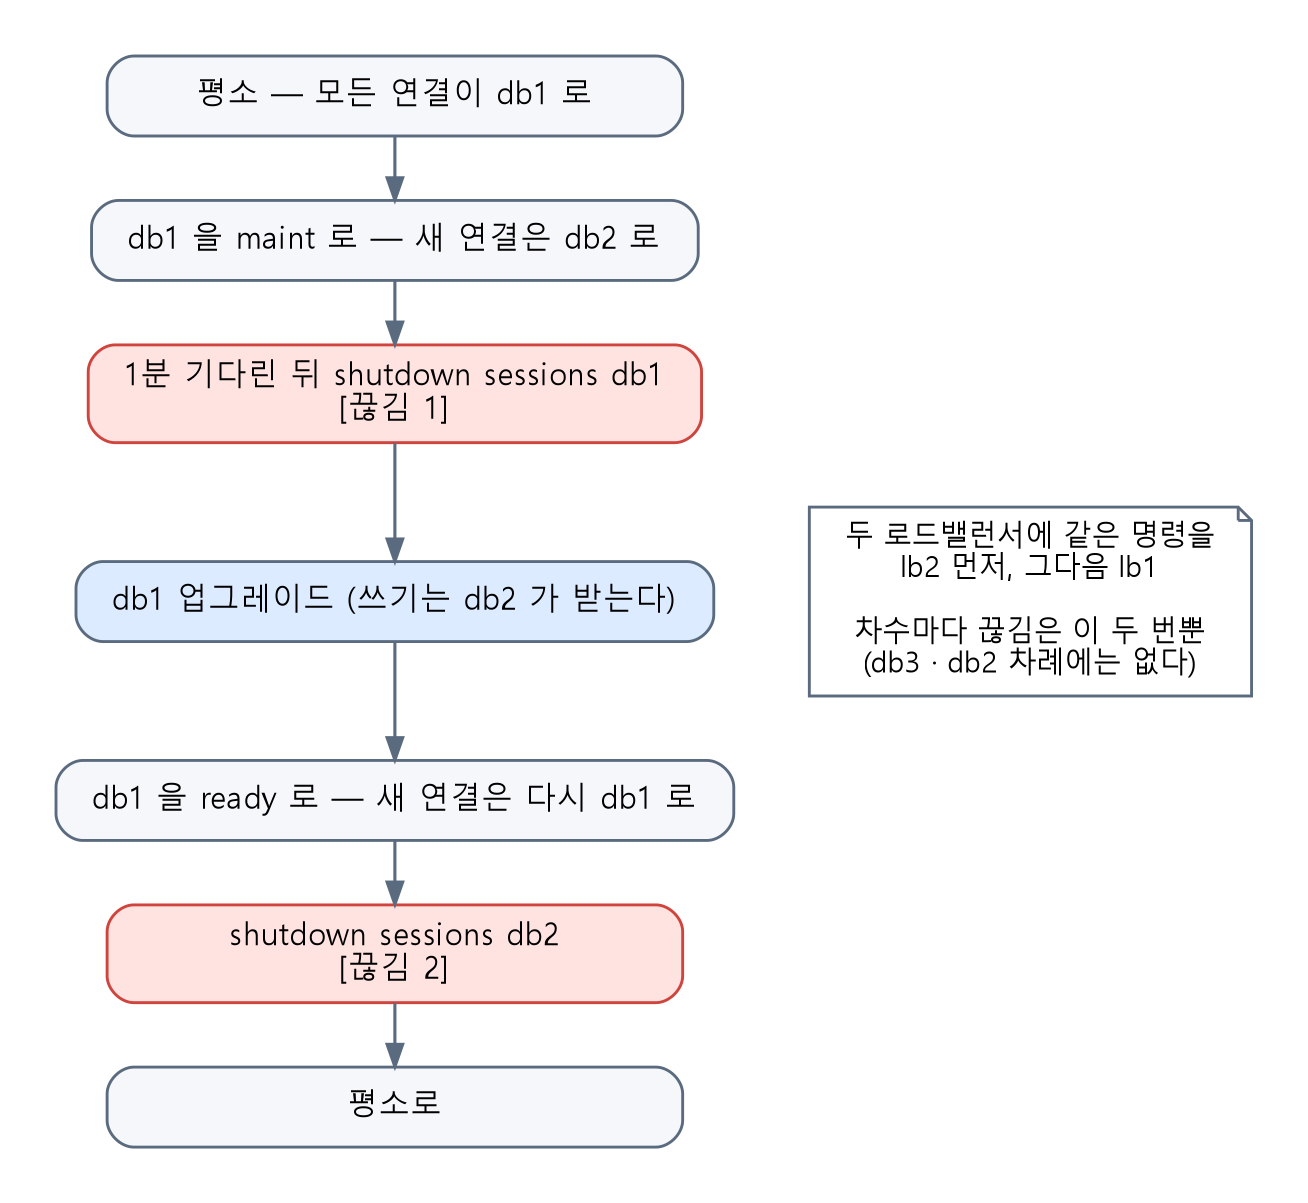
db1 차례에 쓰기 노드를 옮기는 순서

db3·db2 는 연결이 없는 대기 노드라 멈춰도 끊기는 연결이 없다. db1 차례만 HAProxy 런타임 API 로 쓰기를 옮긴다. 두 로드밸런서에 같은 명령을, 대기 쪽 lb2 먼저 보낸다.

# 앞 — db1 을 빼고 남은 세션을 끊는다
echo "set server <백엔드>/db1 state maint"   | nc -U /run/haproxy/admin.sock
# 1분쯤 기다리며 db1 의 Threads_connected 가 0 에 가까운지 본다
echo "shutdown sessions server <백엔드>/db1" | nc -U /run/haproxy/admin.sock     # 끊김 1

# 뒤 — db1 이 Synced 로 돌아오고 mariadb-upgrade 까지 끝나면
echo "set server <백엔드>/db1 state ready"   | nc -U /run/haproxy/admin.sock
echo "shutdown sessions server <백엔드>/db2" | nc -U /run/haproxy/admin.sock     # 끊김 2
  • 끊김은 차수마다 이 두 번뿐이다. 앱이 다시 붙으면 끝난다
  • maint 로 돌려도 풀에 오래 붙어 있는 연결은 남는다. 3차에서는 1분 반이 지나도 10개가 남아 있었다. 기다리지 말고 shutdown sessions 로 끊는 것이 낫다
  • 로드밸런서를 거치지 않는 연결도 있었다. 1차 때 db1 에 바로 붙어 있던 연결 두 개가 db1 을 멈출 때 끊겼다. 미리 세어 보면 누가 바로 붙는지 알 수 있다
  • 읽기를 여러 노드에 나누는 구성이면 노드가 Synced 가 되는 순간 상태 검사를 통과해 읽기가 들어온다. mariadb-upgrade 가 끝날 때까지 그 노드를 로드밸런서에서 maint 로 두는 편이 낫다

8. 스냅샷은 차수 중간에만 쓸모 있다

  • 차수마다 db3 차례에 MariaDB 를 멈춘 뒤, 설치 전에 하이퍼바이저에서 db3 VM 스냅샷을 찍었다. 메모리 없이 디스크 둘(OS·/db) 만. MariaDB 가 멈춰 있어 디스크가 일관된다
  • 그 차수 도중에 문제가 생기면 db3 를 스냅샷으로 되돌려 켠다. 다른 두 노드가 모든 쓰기를 갖고 있으니 IST(또는 같은 판끼리 SST) 로 따라잡는다 — 잃는 것이 없다
  • 차수가 끝나면 그 스냅샷은 쓸 데가 없다. 한 노드만 옛 판으로 되돌릴 수 없고(리허설: Group requested gcs_proto_ver: 6, max supported by this node: 2), 그 스냅샷으로 클러스터를 다시 세우면 스냅샷 뒤의 쓰기를 모두 잃는다. 남겨 두면 씬 풀만 차고 키가 든 디스크 사본이 남는다. 그래서 차수가 끝나면 바로 지웠다
  • 패키지만 옛 판으로 내리는 되돌리기는 안 된다. 10.8 에서 redo 로그 형식이 바뀌었고 11.0 에서 change buffer 가 없어졌다 — 새 판이 한 번 연 /db 는 옛 판이 열지 못한다

9. 결과

차수 날짜 걸린 시간 판 노드가 빠진 시간 (db3 / db2 / db1) IST 여유 끊김
1차 2026-10-01 약 12분 10.6.23 → 10.6.28 48초 / 48초 / 31초 240분 2번
2차 2026-10-02 약 42분 (첫 노드 뒤 30분 지켜본 것 포함) → 10.11.19 48초 / 33초 / 35초 244분 2번
3차 2026-10-06 약 38분 (같음) → 11.4.13 29초 / 36초 / 34초 203분 2번
  • 세 차수 모두 백엔드 DB 오류 0건, 종단 시험(e2e) 네 가지가 앞뒤로 실패 0건
  • 3차 IST 는 노드마다 2,167~2,553건이었고, mariadb-upgrade 는 41·58·91초 걸렸다 (그동안 노드는 이미 클러스터에서 돈다)
  • 3차 뒤 세 노드의 우리 서비스 테이블 수십 개의 체크섬이 같았고, 저장 암호화(file_key_management ACTIVE) 와 TLS 가 그대로였다
  • 지금은 세 노드 모두 MariaDB 11.4.13 · Galera 26.4.27 이다

10. 배운 것

  • 리허설은 운영과 같은 패키지 · 같은 설정이어야 한다. 5절의 함정은 대부분 “판이 바뀌면서 조용히 달라진 것” 이었다. 도커로 세 차수를 끝까지 돌려 본 덕에 운영에서는 놀랄 일이 없었다
  • root 로그인이 막혀 있으면 mariadb-upgrade 에 --user=mysql 을 붙인다. 빼면 root 로 붙어 1045 로 실패한다. 우리 노드는 OS 의 mysql 사용자가 unix_socket 으로 붙는 관리자 계정을 갖고 있었다
  • 기록 파일의 소유자를 본다. 1차 때 /db/mysql_upgrade_info 가 예전에 root 로 만들어져 있어 errno: 13 으로 실패했다. chown mysql:mysql 로 고쳤다. 11.4 는 mariadb_upgrade_info 를 새로 만드는데 mysql:mysql 로 생겨 다시 나지 않았다
  • 재시작 때 debian-start 의 root 1045 는 무해하다. 기동도 apt 도 실패시키지 않는다
  • 마지막 차수 전에 개발 DB 를 먼저 올렸다. 컨테이너 이미지만 10.6.22 → 11.4.13 으로 바꾸고(볼륨은 그대로) 개발 쪽 종단 시험을 돌렸다. 되돌릴 수 있게 볼륨은 깨끗이 멈춘 뒤 따로 떠 두었다
  • 업무 시간에 해도 됐다. 끊김이 차수마다 두 번뿐이라 한가한 시간을 기다리지 않았다

11. 다음

  • OS 24.04 전환 — MariaDB 는 OS 표준 지원이 끝나면 빌드를 멈춘다. jammy 용 11.4 는 2027-06 무렵까지다. noble 에는 10.6 이 없지만 11.4 는 있으니, 클러스터를 먼저 11.4 로 올린 것이 다음 단계의 준비이기도 하다
  • mariabackup SST 검토 — rsync SST 는 donor 를 전송 내내 묶는다. mariabackup 은 끝에 잠깐만 묶는다. 리허설에서는 11.4 에서 TLS·암호화된 테이블까지 넘어갔다
  • 하이퍼바이저 판 올리기와 오래된 노드를 새 서버로 바꾼 이야기는 다음 글에서 다룬다
Proxmox / PR_END_OF_FILE_ERROR

Proxmox 로그인시 아래 메시지가 출력되고 접속이 안되는 상황이 발생

보안 연결 실패

hostname:8006에 연결하는 동안 오류가 발생했습니다. PR_END_OF_FILE_ERROR

오류 코드: PR_END_OF_FILE_ERROR

    받은 데이터의 신뢰성을 확인할 수 없으므로 보시려는 페이지를 표시할 수 없습니다.
    웹 사이트 관리자에게 연락하여 이 문제를 알려주실 수 있습니다.

ssh 접속이 가능하다면 아래 명령어 실행

cd /etc/pve/local ; rm pve*ssl.* ; pvecm updatecerts --force ; service pveproxy restart

OpenWrt 컴파일 for MX4300 (Linksys)

Linksys LN1301 (MX4300)에 OpenWrt를 설치하면서 남기는 글이다.

1. 소스코드

MX4300은 OpenWrt에 정식버전이 없기 때문에 코드를 받아서 컴파일을 해야한다.
아래에서 코드를 다운로드 한다.
https://github.com/qosmio/openwrt-ipq/tree/qualcommax-6.x-nss-mx4300-6.9

2. 환경구축

가상환경에 우분투 24.04.1 LTS를 설치하고 아래 패키지를 설치해준다.

sudo apt update
sudo apt upgrade -y
sudo apt install build-essential clang flex bison g++ gawk gcc-multilib g++-multilib gettext git libncurses-dev libssl-dev python3-distutils python3-setuptools rsync swig unzip zlib1g-dev file wget

3. git clone

git에서 코드를 복제해준다.
아래부터는 root 권한으로 진행하면 컴파일할 때 오류가 발생한다.

cd /home
git clone https://github.com/qosmio/openwrt-ipq -b main-nss-mx4300
cd openwrt-ipq
./scripts/feeds update
./scripts/feeds install -a
cp nss-setup/config-nss.seed .config

추가할 패키지가 있으면 아래명령사용

./scripts/feeds install luci-app-samba4
./scripts/feeds install samba4-server
./scripts/feeds install samba4-utils

.config 파일을 열어서 MX4300 부분의 “is not set”을 수정해준다.

#CONFIG_TARGET_qualcommax_ipq807x_DEVICE_linksys_mx4300 is not set
CONFIG_TARGET_qualcommax_ipq807x_DEVICE_linksys_mx4300=y
make defconfig V=s
make download -j$(nproc) V=s
make -j$(nproc) V=s

4. bin 파일

yell@dev-openwrt:~/openwrt-ipq$ cd bin/targets/qualcommax/ipq807x/
yell@dev-openwrt:~/openwrt-ipq/bin/targets/qualcommax/ipq807x$ ls -al
total 100032
drwxr-xr-x 3 yell yell     4096 Dec 23 08:56 .
drwxr-xr-x 3 yell yell     4096 Dec 23 06:37 ..
-rw-r--r-- 1 yell yell     5873 Dec 23 08:18 config.buildinfo
-rw-r--r-- 1 yell yell      703 Dec 23 08:18 feeds.buildinfo
-rw-r--r-- 1 yell yell 35916962 Dec 23 08:56 kernel-debug.tar.zst
-rw-r--r-- 1 yell yell 21581628 Dec 23 08:56 openwrt-qualcommax-ipq807x-linksys_mx4300-initramfs-uImage.itb
-rw-r--r-- 1 yell yell     8489 Dec 23 08:56 openwrt-qualcommax-ipq807x-linksys_mx4300.manifest
-rw-r--r-- 1 yell yell 24383488 Dec 23 08:56 openwrt-qualcommax-ipq807x-linksys_mx4300-squashfs-factory.bin
-rw-r--r-- 1 yell yell 20490511 Dec 23 08:56 openwrt-qualcommax-ipq807x-linksys_mx4300-squashfs-sysupgrade.bin
drwxr-xr-x 3 yell yell    12288 Dec 23 08:56 packages
-rw-r--r-- 1 yell yell     2026 Dec 23 08:56 profiles.json
-rw-r--r-- 1 yell yell      923 Dec 23 08:56 sha256sums
-rw-r--r-- 1 yell yell       18 Dec 23 08:18 version.buildinfo

googleusercontent.coom / 이미지 표시 문제

사내메일서버에서 지메일로 메일발송할 경우 이미지가 표시안되는 문제가 발생했다.
해당 문제는 본문에 이미지를 삽입했을 때 발생했고 첨부파일로 넣었을 경우는 발생하지 않았다.

문제가 발생한 메일 본문

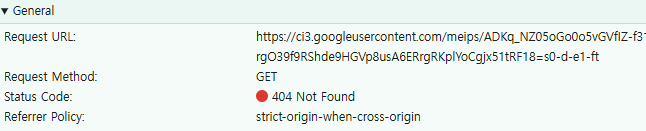
이미지가 나오지 않고 404 코드를 반환한다

<img src="https://ci3.googleusercontent.com/meips/ADKq_NaOOgOCqGIvHrYcYIpTuAvRgcg0AN7kloSXWd4lQFTMeY82IxJGj3p4mMDpxhIyNup7MGJ46SI1UVM30Ldx8JcqQ96BYIIFs4Ppn4B8DbIocydPPcshB-xDUSSmteQnsk9VhU9uHsO6R8i4euJOri1veXp3fyEf1NQ=s0-d-e1-ft#https://mail.domain.com/data/mailing/202404/29/f5abecd29fb2a516346a6cebd02591f39c98a0e8.jpg" class="CToWUd" data-bit="iit" jslog="138226; u014N:xr6bB; 53:WzAsMl0.">

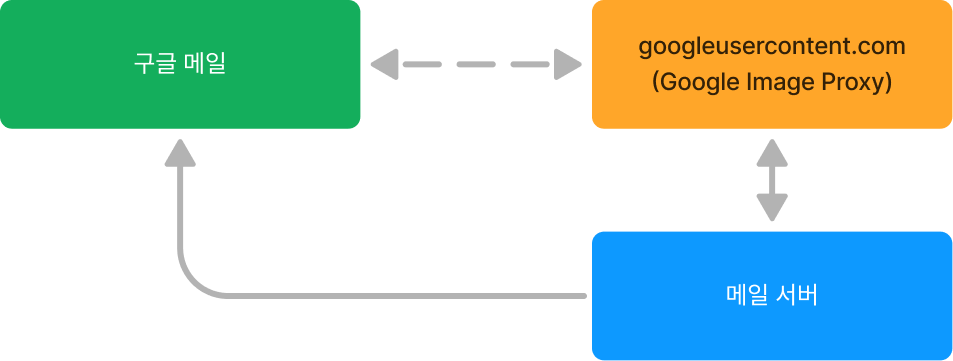
구글메일은 이미지 삽입시 클라이언트에서 읽지 않고 구글 이미지 서버를 거쳐서 캐싱을 한다.

구글링으로 찾아본 해결책

https://stackoverflow.com/questions/40570117/http403-forbidden-error-when-trying-to-load-img-src-with-google-profile-pic

이미지 태그에 referrerPolicy=’no-referrer’ 속성을 추가하는 방법을 안내해준다

결론부터 말하자면 해당 태그를 넣어도 구글에서 해당태그를 아래처럼 없애버린다.

googleusercontent.com

구글 이미지 프록시에서 사내메일서버의 아이피를 블랙리스트로 등록했을
가능성을 생각해보고 우회하는 방법을 생각해봤다.

사내메일서버 아이피를 변경할 수 없는 상황이지만
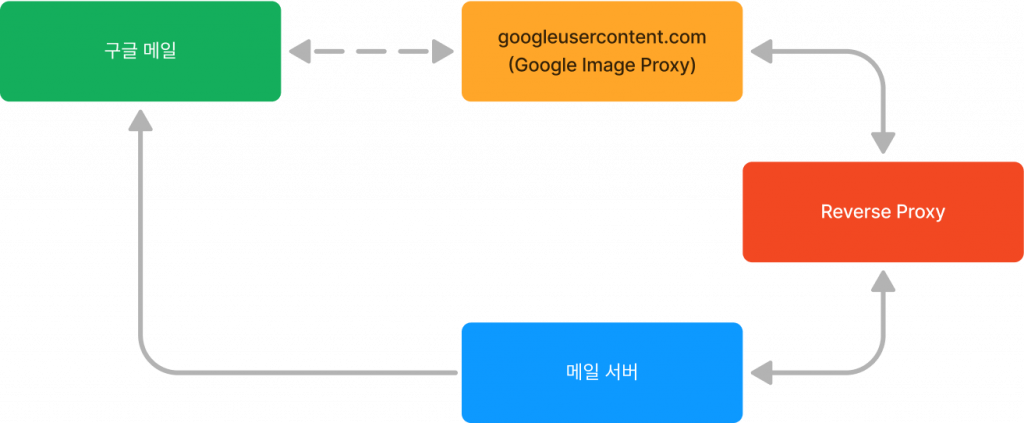
여러 대역의 사용가능한 아이피가 있는 상황이기에 리버스 프록시를 사용해본다.

Reserse proxy / Nginx

구글 이미지 프록시가 메일서버에 직접 접근하는 상황을 아래처럼 변경한다

리버스 프록시 서버는 IDC내 가상서버로 구축하고
4개의 서로 다른 아이피 대역을 할당해줬다.

DNS 설정

img01-mail  IN  A x.1.x.x
img02-mail IN A x.x.2.x
img03-mail IN A 3.x.x.x
img04-mail IN A x.x.x.4

2차 도메인을 DNS서버에 설정한다. 기존 메일서버와는 다른 대역을 사용했다.

메일발송

메일 발송시 본문에서 이미지 태그를 확인하고 도메인 부분을 치환하는 코드를 작성한다.
치환시 img01 ~ img04 중 랜덤하게 사용되도록 해준다.

Nginx 설정

nginx 설정은 따로 특별한게 없다. 도메인만 여러개 추가해준다.

server {
listen 443 ssl http2;
server_name img01-mail.domain.com img02-mail.domain.com img03-mail.domain.com img04-mail.domain.com;
server_tokens off;

location / {
proxy_redirect off;
proxy_pass_header Server;
proxy_set_header Host $http_host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-Proto $scheme;
proxy_pass http://mail.domain.com/;
proxy_redirect off;
proxy_http_version 1.1;
}

ssl_certificate /home/ssl/fullchain.pem;
ssl_certificate_key /home/ssl/_wildcard_domain.com_SHA256WITHRSA.key;
ssl_protocols TLSv1.1 TLSv1.2;
}

테스트

발송할 때마다 2차 도메인은 계속 변경되었고, 이미지도 잘 표시된다.

<img src="https://ci3.googleusercontent.com/meips/ADKq_NaOODCx4XS5A5i2FvMs7IHhVH638Rt18wraT9Lsqo6YmS0oVpeCdEerGQHHdgqODi5uY4s9BZWFfpcGS49R7JJTCOmMG4NH9HLSdVThm7g5tYzRf5go5-gacdoLbsxo3I4r-fOwswrlhRKb-4XjudQPFOC2qznJeSM=s0-d-e1-ft#https://img02-mail.domain.com/data/mailing/202404/29/1b2b7bb8190e4c444ac418b600272d3dbd713e62.jpg" class="CToWUd a6T" data-bit="iit" tabindex="0">

Proxmox VE – Resizing guest disk

Proxmox에서 생성한 VM의 디스크 용량이 부족한 상황이 발생했다.
디스크를 추가하기 보다는 사용중인 디스크의 용량을 증가시키는 방법을 선택하기로 하고 다른 VM에 테스트후 적용했다.

Proxmox WebUI

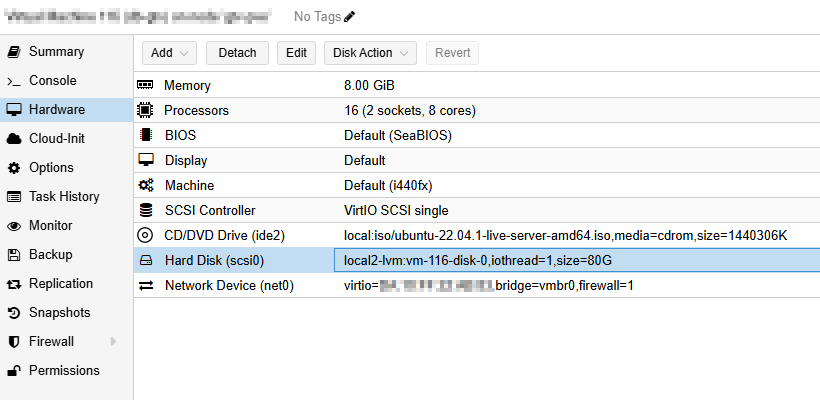
웹UI로 접속해서 해당 VM의 디스크를 선택

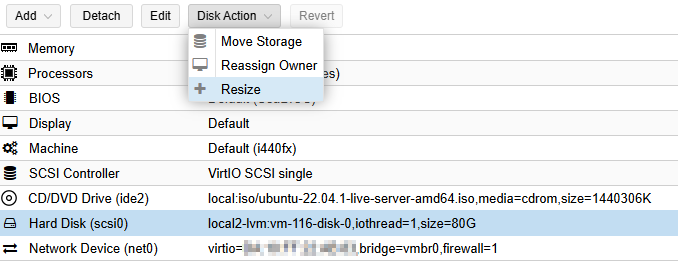
[Disk Action] 에서 [Resize]를 선택하고

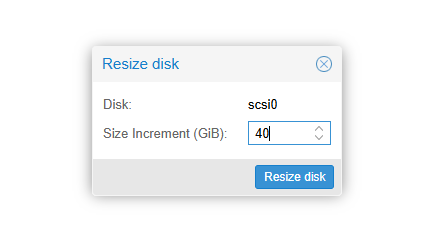
증가시킬 용량을 입력한다

VM에 SSH로 접속

root@db-gtv:~# df -h
Filesystem Size Used Avail Use% Mounted on
tmpfs 794M 1.3M 793M 1% /run
/dev/sda2 79G 73G 2.2G 98% /
tmpfs 3.9G 0 3.9G 0% /dev/shm
tmpfs 5.0M 0 5.0M 0% /run/lock
tmpfs 794M 4.0K 794M 1% /run/user/0

디스크 용량을 확인해 보면 기존 용량으로 보인다.
파티션 조정이 필요해 보인다.

Disk /dev/sda: 120 GiB, 128849018880 bytes, 251658240 sectors
Disk model: QEMU HARDDISK
Units: sectors of 1 * 512 = 512 bytes
Sector size (logical/physical): 512 bytes / 512 bytes
I/O size (minimum/optimal): 512 bytes / 512 bytes
Disklabel type: gpt
Disk identifier: 853010EE-DB5B-4D1D-BF27-A8485BA881EE

Device Start End Sectors Size Type
/dev/sda1 2048 4095 2048 1M BIOS boot
/dev/sda2 4096 167770111 167766016 80G Linux filesystem

디스크의 파티션을 확인한다. Proxmox WebUI에서 조정한만큼 용량이 증가한 것을 확인할 수 있다.

root@db-gtv:~# growpart /dev/sda 2
CHANGED: partition=2 start=4096 old: size=167766016 end=167770112 new: size=251654111 end=251658207

growpart 명령을 이용해서 파티션을 조정한다.

root@db-gtv:~# resize2fs /dev/sda2
resize2fs 1.46.5 (30-Dec-2021)
Filesystem at /dev/sda2 is mounted on /; on-line resizing required
old_desc_blocks = 10, new_desc_blocks = 15
The filesystem on /dev/sda2 is now 31456763 (4k) blocks long.

resize2fs 명령을 이용해서 파일시스템도 조절해준다.

root@db-gtv:~# df -h
Filesystem Size Used Avail Use% Mounted on
tmpfs 794M 1.3M 793M 1% /run
/dev/sda2 118G 73G 40G 65% /
tmpfs 3.9G 0 3.9G 0% /dev/shm
tmpfs 5.0M 0 5.0M 0% /run/lock
tmpfs 794M 4.0K 794M 1% /run/user/0

증가된 용량을 확인할 수 있다.

라즈베리파이를 무선공유기로 만들기

https://www.raspberrypi.com/software/operating-systems

라즈베리파이 이미지중 Raspberry Pi OS Lite 를 설치하고 진행한다.

필수 패키지 설치

apt install -y hostapd
apt install -y dnsmasq

설정파일

interface=wlan1
driver=nl80211
ssid=jongwan
hw_mode=g
channel=7
wmm_enabled=0
macaddr_acl=0
auth_algs=1
ignore_broadcast_ssid=0
wpa=2
wpa_passphrase=12345678
wpa_key_mgmt=WPA-PSK
wpa_pairwise=TKIP
rsn_pairwise=CCMP

/etc/hostapd/hostapd.conf

interface=wlan1
dhcp-range=192.168.10.2,192.168.10.20,255.255.255.0,24h
domain=wlan
address=/gw.wlan/192.168.10.1

/etc/dnsmasq.conf

# 아래 내용 추가
interface wlan1
static ip_address=192.168.10.1/24
nohook wpa_supplicant

/etc/dhcpcd.conf

# 아래 주석 해제
#net.ipv4.ip_forward=1

/etc/sysctl.conf

root@raspberrypi:/# sysctl -p
net.ipv4.ip_forward = 1
sudo iptables -t nat -A POSTROUTING -o eth0 -j MASQUERADE

서비스 실행

systemctl unmask hostapd
systemctl enable hostapd
systemctl start hostapd
systemctl enable dnsmasq
systemctl start dnsmasq

HAProxy + Apache2 웹서비스 이중화 구성하기

HAProxy 설치

우분투 22.04 기준 패키지 매니저로 설치한다.

apt install haproxy

haproxy.cfg

global
        log /dev/log    local0
        log /dev/log    local1 notice
        chroot /var/lib/haproxy
        stats socket /run/haproxy/admin.sock mode 660 level admin expose-fd listeners
        stats timeout 30s
        user haproxy
        group haproxy
        daemon

        # Default SSL material locations
        ca-base /etc/ssl/certs
        crt-base /etc/ssl/private

        ssl-default-bind-options no-sslv3
        ssl-default-bind-ciphers ECDH+AESGCM:DH+AESGCM:ECDH+AES256:DH+AES256:ECDH+AES128:DH+AES:ECDH+3DES:DH+3DES:RSA+AESGCM:RSA+AES:RSA+3DES:!aNULL:!MD5:!DSS
        ssl-default-server-options no-sslv3
        ssl-default-server-ciphers ECDH+AESGCM:DH+AESGCM:ECDH+AES256:DH+AES256:ECDH+AES128:DH+AES:ECDH+3DES:DH+3DES:RSA+AESGCM:RSA+AES:RSA+3DES:!aNULL:!MD5:!DSS

defaults
        log     global
        mode    http
        option  httplog
        option  dontlognull
        timeout connect 5000
        timeout client  50000
        timeout server  50000
        errorfile 400 /etc/haproxy/errors/400.http
        errorfile 403 /etc/haproxy/errors/403.http
        errorfile 408 /etc/haproxy/errors/408.http
        errorfile 500 /etc/haproxy/errors/500.http
        errorfile 502 /etc/haproxy/errors/502.http
        errorfile 503 /etc/haproxy/errors/503.http
        errorfile 504 /etc/haproxy/errors/504.http

####################################################
# stats
####################################################
listen stats
        bind *:8080
        stats enable
        stats uri /
        stats realm HAProxy\ Statistics
        stats auth admin:1234
        stats refresh 5s

####################################################
# jongwan.com
####################################################
frontend jongwan_com-front
        mode http
        bind 172.16.0.10:80
        redirect scheme https code 301 if !{ ssl_fc }

frontend jongwan_com-ssl-front
        mode http
        bind 172.16.0.10:443 ssl crt /etc/haproxy/ssl/_wildcard_jongwan_com.pem
        default_backend jongwan_com-backend

backend jongwan_com-backend
        mode http
        option httpchk
        option forwardfor
        http-request set-header X-Forwarded-Port %[dst_port]
        http-request set-header X-Forwarded-Proto https if { ssl_fc }
        http-request set-header X-Forwarded-Proto http if !{ ssl_fc }
        server www1 10.0.0.1:80 check weight 1
        server www2 10.0.0.2:80 check weight 1 backup
listen stats
        bind *:8080
        stats enable
        stats uri /
        stats realm HAProxy\ Statistics
        stats auth admin:1234
        stats refresh 5s

stat은 8080포트로 바인딩하고 암호를 설정해준다.

frontend jongwan_com-front
        mode http
        bind 172.16.0.10:80
        redirect scheme https code 301 if !{ ssl_fc }

프런트앤드를 추가한다.

  • bind : 외부에서 접근하는 아이피 (공인아이피)
  • redirect : https 포트로 리다이렉트한다.
frontend jongwan_com-ssl-front
        mode http
        bind 172.16.0.10:443 ssl crt /etc/haproxy/ssl/_wildcard_jongwan_com.pem
        default_backend jongwan_com-backend

HTTPS 프런트앤드를 설정한다.

  • bind : 외부에서 접근하는 아이피를 입력한다. PEM 형식의 인증서를 추가해야 하고 아래쪽에 만드는 방법이 있다.
  • default_backend : 기본 백앤드
backend jongwan_com-backend
        mode http
        option httpchk
        option forwardfor
        http-request set-header X-Forwarded-Port %[dst_port]
        http-request set-header X-Forwarded-Proto https if { ssl_fc }
        http-request set-header X-Forwarded-Proto http if !{ ssl_fc }
        server www1 10.0.0.1:80 check weight 1
        server www2 10.0.0.2:80 check weight 1 backup
  • mode : http 방식으로 health 체크를 한다. ssl 확인을 위해 header를 사용하기 때문에 tcp로 하면 동작하지 않는다.
  • server : 실제 웹서버 정보를 입력한다. 사용자와 통신은 443 (SSL) 통신을 하지만 haproxy와 webserver간에는 80으로 통신한다.

아파치 웹서버 설정

<VirtualHost *:80>
        ServerAdmin aiseki@gmail.com
        DocumentRoot /home/jongwan/public_html
        ServerName jongwan.com
        ServerAlias www.jongwan.com

        <Directory /home/jongwan/public_html/>
                Options FollowSymLinks
                AllowOverride FileInfo
                Require all granted
        </Directory>

        RemoteIPHeader X-Forwarded-For
        RemoteIPInternalProxy 172.16.0.10/24

        #LogLevel info ssl:warn
        ErrorLog ${APACHE_LOG_DIR}/error.log
        CustomLog ${APACHE_LOG_DIR}/access.log combined

</VirtualHost>
  • RemoteIPHeader X-Forwarded-For : 사용자는 haproxy를 통해서 웹서버에 접근하기 때문에 실제 웹서버 로그에는 haproxy 아이피가 나온다. 이때 haproxy는 X-Forwarded-For 헤더에 클라이언트의 실제아이피를 담아준다.
    mod_remoteip 모듈을 활성화하고 해당 옵션을 이용하면 아파치가 실제 클라이언트 아이피를 가져올 수 있다.
    PHP의 경우 REMOTE_ADDR 값에 영향을 준다.
  • RemoteIPInternalProxy : haproxy 아이피 대역을 입력한다.

mod_remoteip 활성화하기

a2enmod remoteip

PEM 인증서 생성하기

key, crt 파일을 이용해서 pem 형식의 인증서를 만드는 방법이다.
합친파일에서 ^M 문자열이 있을 경우 오류가 나기 때문에 tr 명령을 이용해서 삭제해준다.

cat _wildcard_jongwan_com_SHA256WITHRSA.key _wildcard_jongwan_com.crt ChainCA/rsa-dv.chain-bundle.pem | tr -d '\015' > _wildcard_jongwan_com.pem

외부스크립트를 이용해서 HAProxy node 체크하기

HAProxy + MariaDB Galera Cluster 구성을 하고 테스트를 진행하니 문제가 발생해서 글을 남겨본다.

HAProxy

haproxy.cfg 설정파일에서 아래 옵션을 사용

option mysql-check user haproxy

이 옵션은 TCP 포트로의 접속가능 여부만 판단해서 health check를 한다.
Galera Cluster의 경우 노드가 복구될 때 쿼리를 하면 아래 메시지가 출력된다.

WSREP has not yet prepared node for application use

따라서 이 경우는 HAProxy에서 노드를 살려줘서는 안된다.

MariaDB Galera Cluster

MariaDB [(none)] > show global status where variable_name='wsrep_local_state';
+-------------------+-------+
| Variable_name     | Value |
+-------------------+-------+
| wsrep_local_state | 4     |
+-------------------+-------+

동기화가 완료되서 사용이 가능한 상태값이다.
다른 상태값은 아래 링크에서 확인한다.
https://mariadb.com/docs/ent/ref/mdb/status-variables/wsrep_local_state/

HAProxy external-check

기존에 mysql-check를 외부 스크립트를 이용하도록 변경한다.
외부 스크립트는 wsrep_local_state 값을 읽어서 원하는 값이면 exit 0 을 리턴하고 다른값이면 exit 255를 리턴시켜주면 된다.

/etc/haproxy/haproxy.cfg

global
        log /dev/log    local0
        log /dev/log    local1 notice	
        stats socket /run/haproxy/admin.sock mode 660 level admin expose-fd listeners
        stats timeout 30s
        user haproxy
        group haproxy
        daemon
        external-check
        insecure-setuid-wanted

frontend mysql-front
        bind *:3306
        mode tcp
        default_backend mysql-back

backend mysql-back
        mode tcp        
	#option mysql-check user haproxy
	option external-check
        external-check path "/usr/bin:/bin"
        external-check command /etc/haproxy/script/check_node.sh
	balance roundrobin
        server db1 172.16.0.20:3306 check
        server db2 172.16.0.21:3306 check backup weight 2
        server db3 172.16.0.22:3306 check backup weight 1
  1. global 항목에 external-check 값이 추가되었다.
  2. external-check를 사용하기위해서 insecure-setuid-wanted 값을 추가해야한다
    https://www.haproxy.com/blog/announcing-haproxy-2-2/#security-hardening
  3. backend 항목에 기존 mysql-check 항목을 external-check로 변경
  4. external-check path 추가
  5. external-check command 추가

/etc/haproxy/script/check_node.sh

#!/bin/bash

MYSQL_HOST="$3"
MYSQL_PORT="$4"
MYSQL_USERNAME="haproxy"
MYSQL_PASSWORD=""
MYSQL_BIN="/bin/mysql"
MYSQL_OPTS="--no-defaults --connect-timeout=10 -snNE"
CMDLINE="$MYSQL_BIN $MYSQL_OPTS --host=$MYSQL_HOST --port=$MYSQL_PORT --user=$MYSQL_USERNAME -e"
WSREP_LOCAL_STATE_CHK=`$CMDLINE "SHOW GLOBAL STATUS WHERE VARIABLE_NAME='wsrep_local_state'" | tail -1`

if [ "$WSREP_LOCAL_STATE_CHK" != "4" ]; then
    exit 255
fi

exit 0

파라메터 정보

$1 = Virtual Service IP (VIP)
$2 = Virtual Service Port (VPT)
$3 = Real Server IP (RIP)
$4 = Real Server Port (RPT) 
$5 = Check Source IP 

$3, $4를 이용해서 노드의 상태를 읽는다.

HAProxy + Galera Cluster (MariaDB) 2/2

HAProxy

우분투 20.04 에서 진행한다. 패키지관리자로 설치가 가능하다. SSL을 지원하는 2.x 버전이 설치된다.

apt install -y haproxy
root@haproxy1:~# haproxy --version
HA-Proxy version 2.0.29-0ubuntu1 2022/08/26 - https://haproxy.org/
Usage : haproxy [-f <cfgfile|cfgdir>]* [ -vdVD ] [ -n <maxconn> ] [ -N <maxpconn> ]
        [ -p <pidfile> ] [ -m <max megs> ] [ -C <dir> ] [-- <cfgfile>*]
        -v displays version ; -vv shows known build options.
        -d enters debug mode ; -db only disables background mode.
        -dM[<byte>] poisons memory with <byte> (defaults to 0x50)
        -V enters verbose mode (disables quiet mode)
        -D goes daemon ; -C changes to <dir> before loading files.
        -W master-worker mode.
        -Ws master-worker mode with systemd notify support.
        -q quiet mode : don't display messages
        -c check mode : only check config files and exit
        -n sets the maximum total # of connections (uses ulimit -n)
        -m limits the usable amount of memory (in MB)
        -N sets the default, per-proxy maximum # of connections (0)
        -L set local peer name (default to hostname)
        -p writes pids of all children to this file
        -de disables epoll() usage even when available
        -dp disables poll() usage even when available
        -dS disables splice usage (broken on old kernels)
        -dG disables getaddrinfo() usage
        -dR disables SO_REUSEPORT usage
        -dr ignores server address resolution failures
        -dV disables SSL verify on servers side
        -sf/-st [pid ]* finishes/terminates old pids.
        -x <unix_socket> get listening sockets from a unix socket
        -S <bind>[,<bind options>...] new master CLI

haproxy 설정

파일을 생성하거나 수정해야 한다. 각 HAProxy 노드별로 설정파일이 같다.

/etc/haproxy/haproxy.cfg

global
        log /dev/log    local0
        log /dev/log    local1 notice
        chroot /var/lib/haproxy
        stats socket /run/haproxy/admin.sock mode 660 level admin expose-fd listeners
        stats timeout 30s
        user haproxy
        group haproxy
        daemon

        # Default SSL material locations
        ca-base /etc/ssl/certs
        crt-base /etc/ssl/private

        # See: https://ssl-config.mozilla.org/#server=haproxy&server-version=2.0.3&config=intermediate
        ssl-default-bind-ciphers ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305:DHE-RSA-AES128-GCM-SHA256:DHE-RSA-AES256-GCM-SHA384
        ssl-default-bind-ciphersuites TLS_AES_128_GCM_SHA256:TLS_AES_256_GCM_SHA384:TLS_CHACHA20_POLY1305_SHA256
        ssl-default-bind-options ssl-min-ver TLSv1.2 no-tls-tickets

defaults
        log     global
        mode    http
        option  httplog
        option  dontlognull
        timeout connect 5000
        timeout client  50000
        timeout server  50000
        errorfile 400 /etc/haproxy/errors/400.http
        errorfile 403 /etc/haproxy/errors/403.http
        errorfile 408 /etc/haproxy/errors/408.http
        errorfile 500 /etc/haproxy/errors/500.http
        errorfile 502 /etc/haproxy/errors/502.http
        errorfile 503 /etc/haproxy/errors/503.http
        errorfile 504 /etc/haproxy/errors/504.http

listen stats
        bind *:8080
        stats enable
        stats uri /
        stats realm HAProxy\ Statistics
        stats auth admin:1234
        stats refresh 10s

frontend mysql-front
        bind *:3306
        mode tcp
        default_backend mysql-back

backend mysql-back
        mode tcp
        option mysql-check user haproxy
        balance roundrobin
        server db1 172.16.0.20:3306 check
        server db2 172.16.0.21:3306 check backup weight 2
        server db3 172.16.0.22:3306 check backup weight 1

이 설정은 db1 노드를 Active 상태로 두고 나머지는 stand-by한다. db1 노드에 장애가 발생하면 다음번 노드가 활성화된다.

mysql-check 옵션

백엔드에 입력된 노드상태 확인을 위해서 mysql 접근이 가능해야한다. 따라서 각 데이터베이스 노드에 haproxy 유저를 추가해준다.

MariaDB [(none)] > create user 'haproxy'@'172.16.0.%';

Keepalived

HAProxy를 이중화하기 위해서 keepalived가 필요하다. VIP를 가지고 있다가 마스터 노드에 장애가 발생하면 슬래이브 노드에 VIP를 바인딩해준다.

apt install -y keepalived

로컬 호스트주소외 다른 가상아이피를 바인딩할 수 있도록 설정을 변경해야 한다.
아래파일에 추가하거나 수정한다.

/etc/sysctl.conf

net.ipv4.ip_nonlocal_bind = 1
root@haproxy1:/etc/keepalived# sysctl -p
net.ipv4.ip_nonlocal_bind = 1

HAProxy 1번노드

/etc/keepalived/keepalived.conf

global_defs {
        router_id HAProxy1
}

vrrp_script check_haproxy {
        script "killall -0 haproxy"
        interval 2
        weight 2
}

vrrp_instance VIS_TEST {
        interface         eth0
        state             MASTER
        priority          101
        virtual_router_id 51
        advert_int        1

        virtual_ipaddress {
                172.16.0.5
        }

        track_script {
                check_haproxy
        }
}

HAProxy 2번노드

/etc/keepalived/keepalived.conf

global_defs {
        router_id HAProxy2
}

vrrp_script check_haproxy {
        script "killall -0 haproxy"
        interval 2
        weight 2
}

vrrp_instance VIS_TEST {
        interface         eth0
        state             MASTER
        priority          100
        virtual_router_id 51
        advert_int        1

        virtual_ipaddress {
                172.16.0.5
        }

        track_script {
                check_haproxy
        }
}

router_id 값은 각 노드마다 다르다.
priority 값은 마스터가 값이 더 커야 한다.
virtual_ipaddress 값은 VIP로 마스터가 이 VIP를 바인딩하다 장애가 발생하면 다른 노드가 이 VIP를 바인딩해서 이중화가 가능하다.

서비스 재시작

systemctl restart keepalived.service

네트워크 확인

1번 노드에 VIP가 바인딩된 것이 보인다. 1번노드에서 haproxy 서비스를 중지시키면 2번 노드에 VIP가 바인딩되는 것을 확인할 수 있다.

root@haproxy1:/etc/haproxy# ip a
2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP group default qlen 1000
    link/ether xx:xx:xx:xx:xx:xx brd ff:ff:ff:ff:ff:ff
    inet 172.16.0.10/24 brd 172.16.0.255 scope global eth0
       valid_lft forever preferred_lft forever
    inet 172.16.0.5/32 scope global eth0
       valid_lft forever preferred_lft forever
root@haproxy2:/etc/haproxy# ip a
2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP group default qlen 1000
    link/ether xx:xx:xx:xx:xx:xx brd ff:ff:ff:ff:ff:ff
    inet 172.16.0.11/24 brd 172.16.0.255 scope global eth0
       valid_lft forever preferred_lft forever