운영 중인 MariaDB Galera 클러스터 세 대를 10.6 에서 11.4 로 올렸다. 2026-10-01 에 시작해 10-06 에 끝났고, 세 번 모두 업무 시간에 서비스를 켜 둔 채로 했다. 이 글은 그 과정과, 미리 리허설을 돌려 보지 않았다면 운영에서 처음 만났을 함정들을 정리한 것이다. 같은 일을 앞둔 사람이 순서대로 따라 할 수 있게 썼다.
1. 왜 올렸나
- 10.6 은 커뮤니티 지원이 2026-07-06 에 끝났다. 마지막 판 10.6.28(2026-08-13) 의 릴리스 노트에는 “This is the final release in the MariaDB 10.6 series.” 라고 적혀 있다
- 그런데 우분투 22.04 패키지는 10.6.23 에 머물러 있었다. jammy-updates 의 최신이 10.6.23 이고, 10.6.28 에 들어간 보안 수정(Galera 쪽 MDEV-40027·MDEV-40056 — SUPER 권한 사용자가 셸 명령을 실행할 수 있던 문제 둘 포함)을 받을 길이 없었다
- 보안 인증 심사의 패치 관리 항목 에서 지적받을 수 있는 상태였다
- 새 하드웨어는 없었다. 임시 노드를 붙여 새 클러스터로 넘기는 안은 접고, 지금 세 노드를 한 대씩 올리기로 했다
- 목표를 11.4 로 잡은 이유: 10.11 의 지원은 2028-02-16 에, 11.4 는 2029-05-29 에 끝난다. 11.4 는 우분투 22.04(jammy)·24.04(noble) 둘 다 공식 패키지가 있어 다음 OS 전환도 수월하다
2. 환경
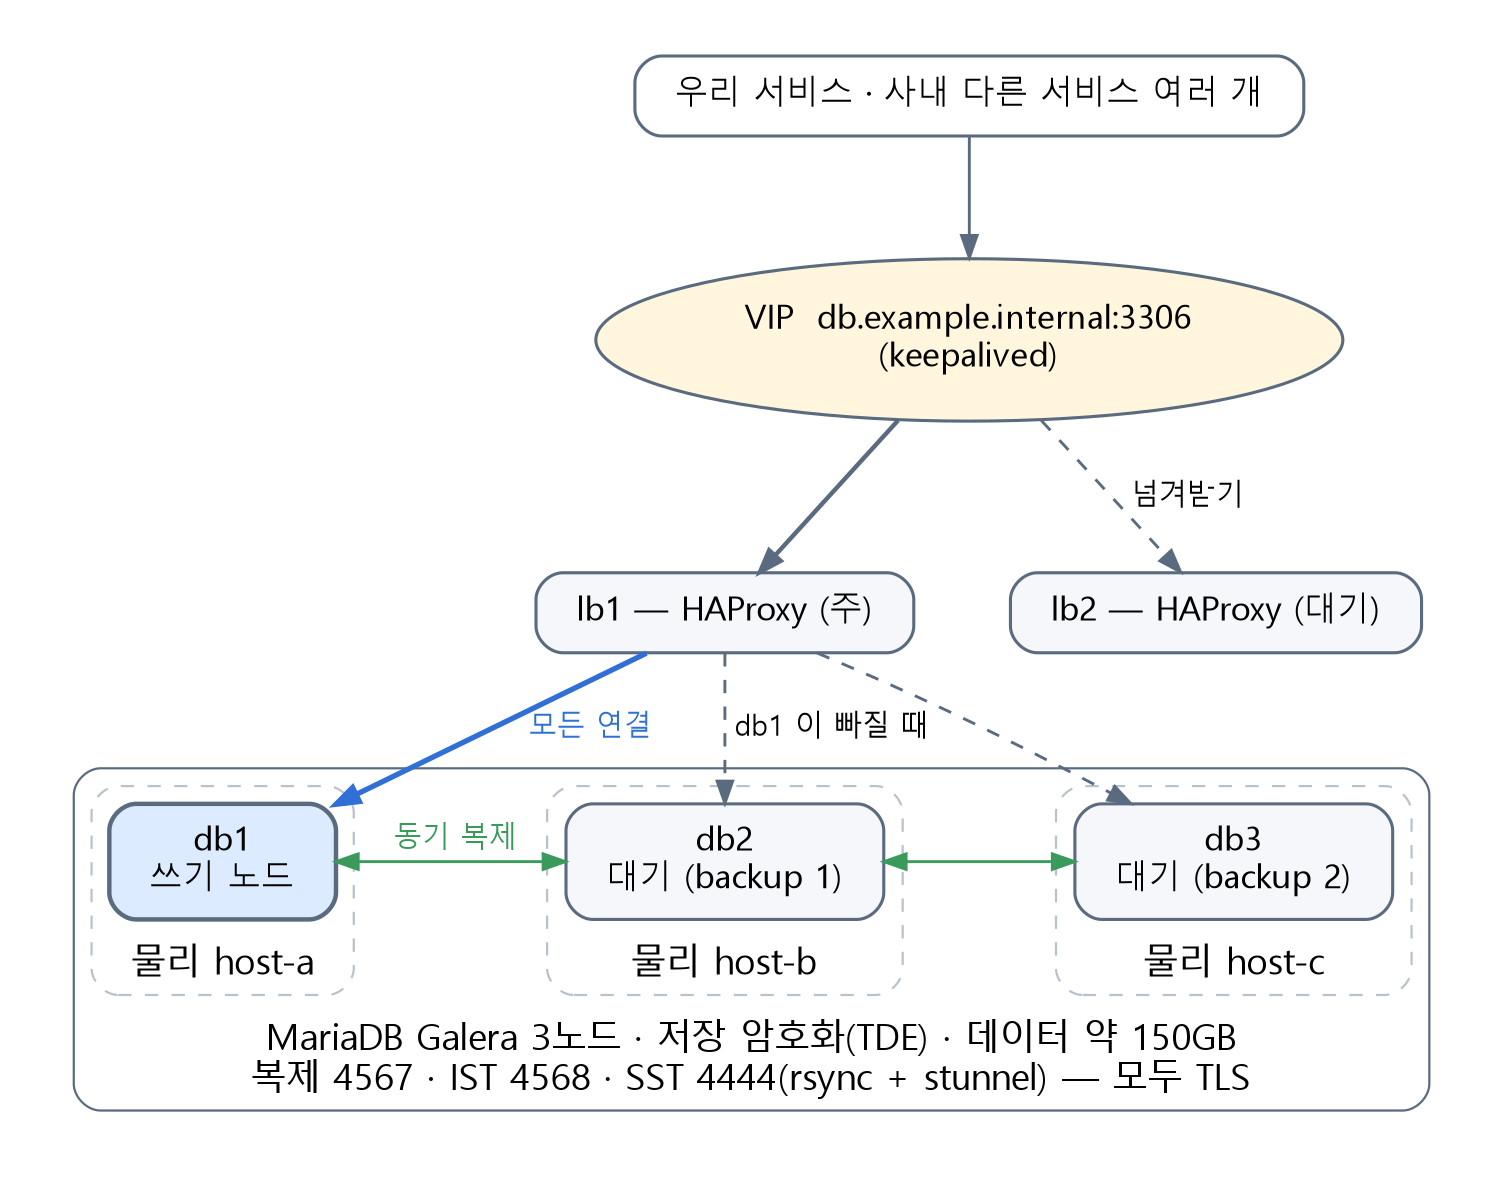
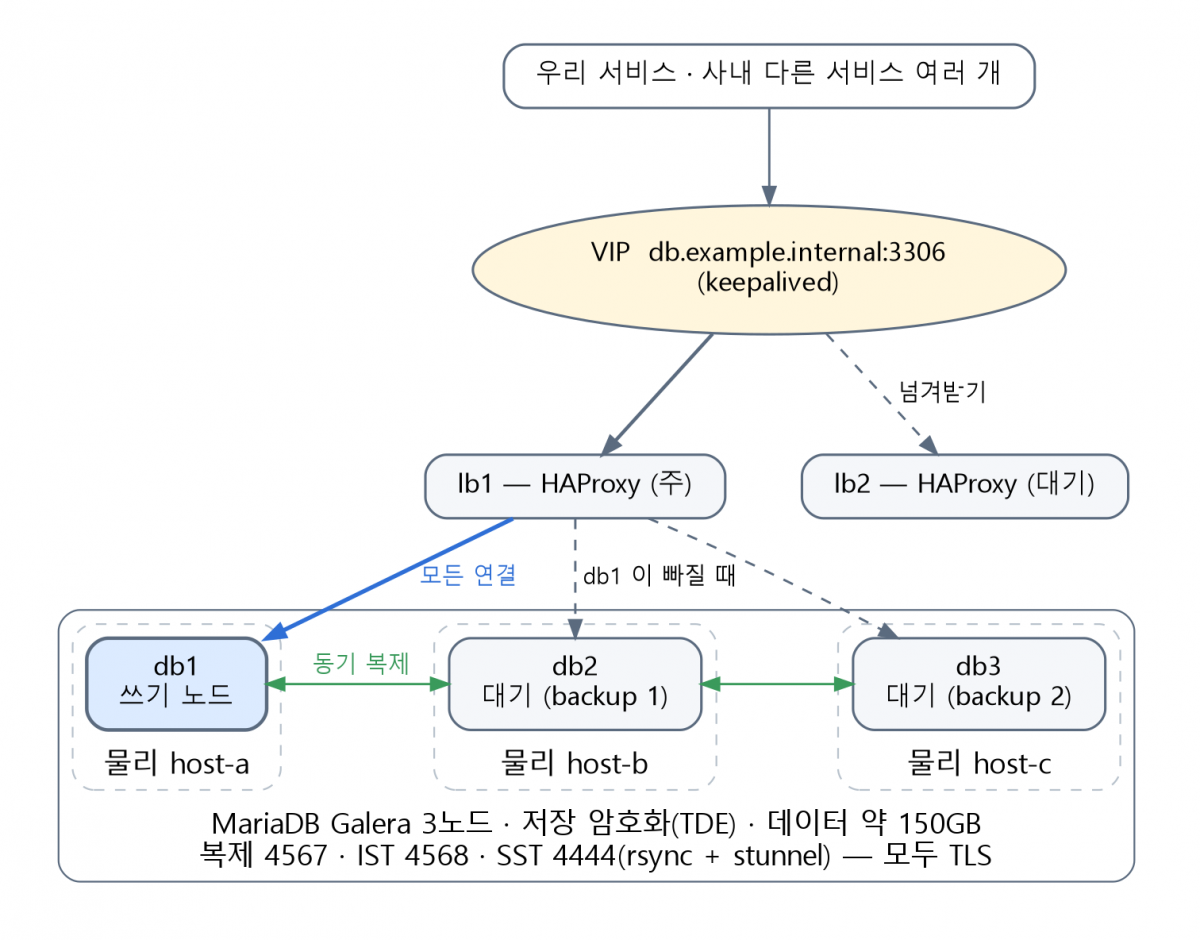
이 구성은 예전 글 HAProxy + Galera Cluster (MariaDB) 1/2, 2/2 에서 다뤘다. 그 뒤로 바뀐 것까지 합치면 지금은 이렇다.
- 노드: 우분투 22.04 VM 세 대 (
db1·db2·db3). 노드마다 다른 물리 호스트에 있다. 데이터 디렉터리/db는 OS 와 다른 디스크이고 데이터는 약 150GB 다 - 앞단: HAProxy 두 대(
lb1·lb2) 와 keepalived VIP. 모든 연결을 db1 하나로 보내고 db2·db3 는 backup 으로 둔다. 쓰기 노드가 하나라 Galera 의 인증 충돌을 걱정할 일이 없다 - 상태 검사: 외부 스크립트로 HAProxy 노드를 검사한다. 노드가
Synced(wsrep_local_state=4) 일 때만 UP 이다 — 업그레이드 중인 노드는 저절로 빠진다 - 암호화: 저장 암호화(TDE,
file_key_management) 로 우리 서비스 테이블을 암호화했고, 3306 · Galera 복제(4567) · IST(4568) · SST(4444, rsync + stunnel) 를 모두 TLS 로 감쌌다 - 쓰기량: 시간당 0.5GB 안팎, gcache 는 2GB 다
- 함께 쓰는 곳: 우리 서비스 말고도 사내 다른 서비스 여러 개가 같은 클러스터를 쓴다. 그래서 끊김을 줄이는 것이 가장 중요했다
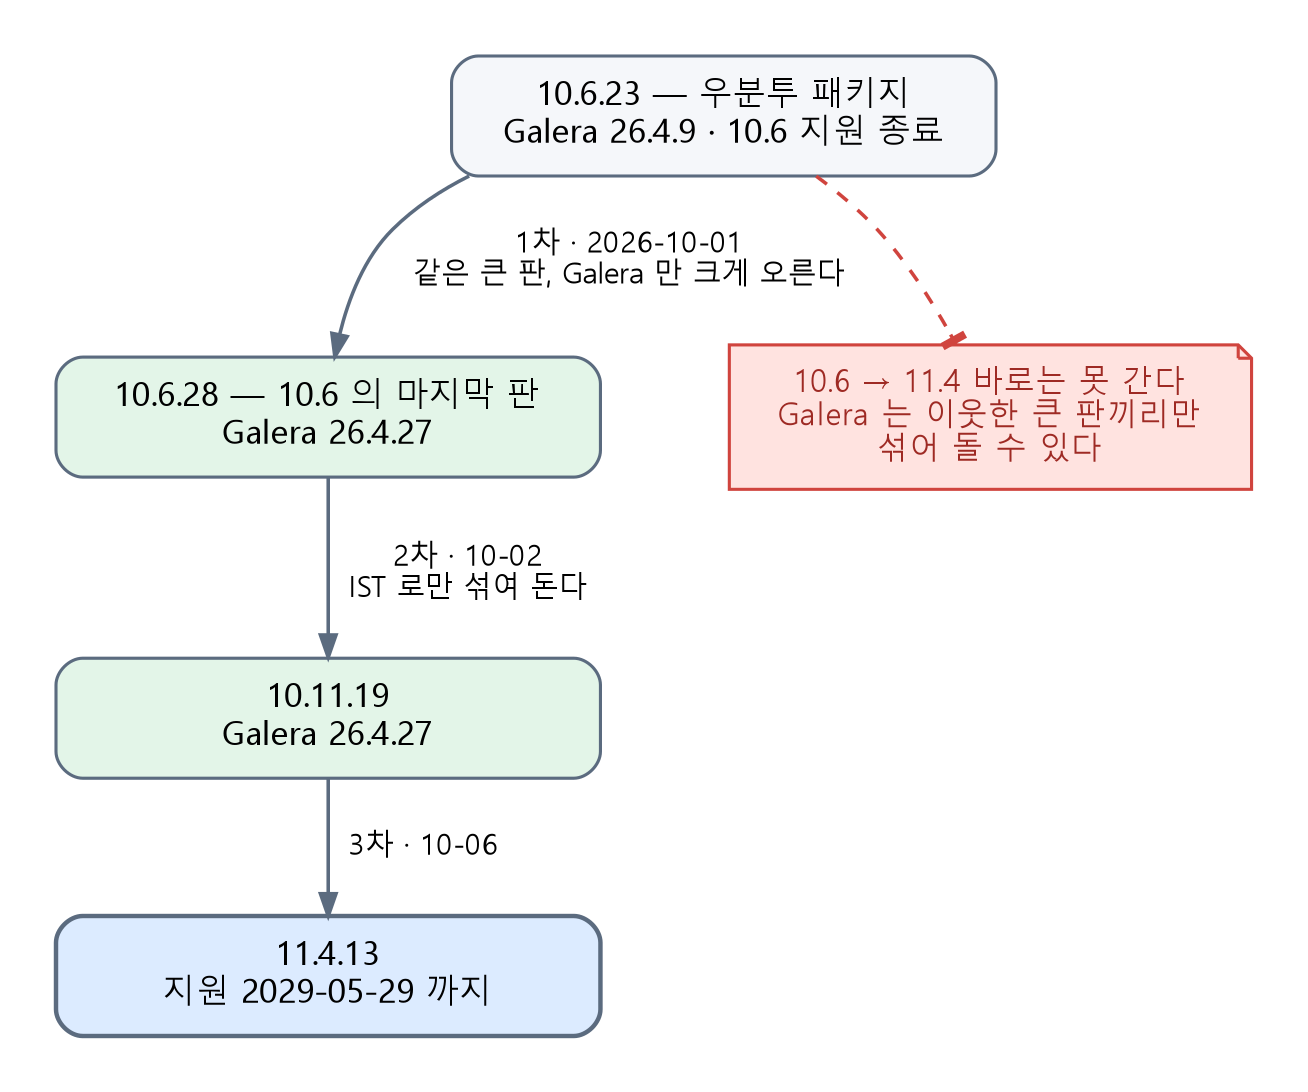
3. 한 번에 못 간다 — 경로
| 차수 | 판 | Galera | 패키지 이름 |
|---|---|---|---|
| 1차 | 10.6.23(우분투) → 10.6.28 | 26.4.9 → 26.4.27 | 같다 (mariadb-server-10.6 …) |
| 2차 | 10.6.28 → 10.11.19 | 그대로 | 바뀐다 — -10.6 이 붙은 이름이 지워지고 판 없는 이름이 들어온다 |
| 3차 | 10.11.19 → 11.4.13 | 그대로 | 같다 + -compat 패키지 둘이 더 들어온다 |
- 10.6 에서 11.4 로 바로 가는 롤링은 없다. Galera 는 이웃한 큰 판끼리만 섞어 돌 수 있다
- 10.6 → 10.11 은 IST 로만 롤링된다. 공식 문서의 표현은 “rolling upgrade with IST is supported, but rolling upgrade with SST does not work for this jump” 다
- 그래서 10.6 의 최신(10.6.28) 을 먼저 거친다. 문서: “If you are upgrading from the most recent MariaDB 10.6 release to MariaDB 10.11, then the versions will be compatible.”
- 1차에서 Galera 가 26.4.9 → 26.4.27 로 크게 오른다. 사이에 GCS 프로토콜이 여러 번 바뀌었다. 섞여 있는 동안은 옛 프로토콜로 돌다가 세 노드가 다 오르면 새 프로토콜로 넘어가고, 그때부터는 한 노드만 되돌릴 수 없다 (“prevents downgrades of individual nodes in the cluster as soon as all nodes have been updated”)
- 패키지 출처가 바뀐다. 우분투 저장소에서 MariaDB 공식 저장소로 옮긴다. 판은 끝자리까지 고정한다 — 리허설한 판과 운영에 들어가는 판이 같아야 한다
4. IST 와 SST, 그리고 gcache 여유
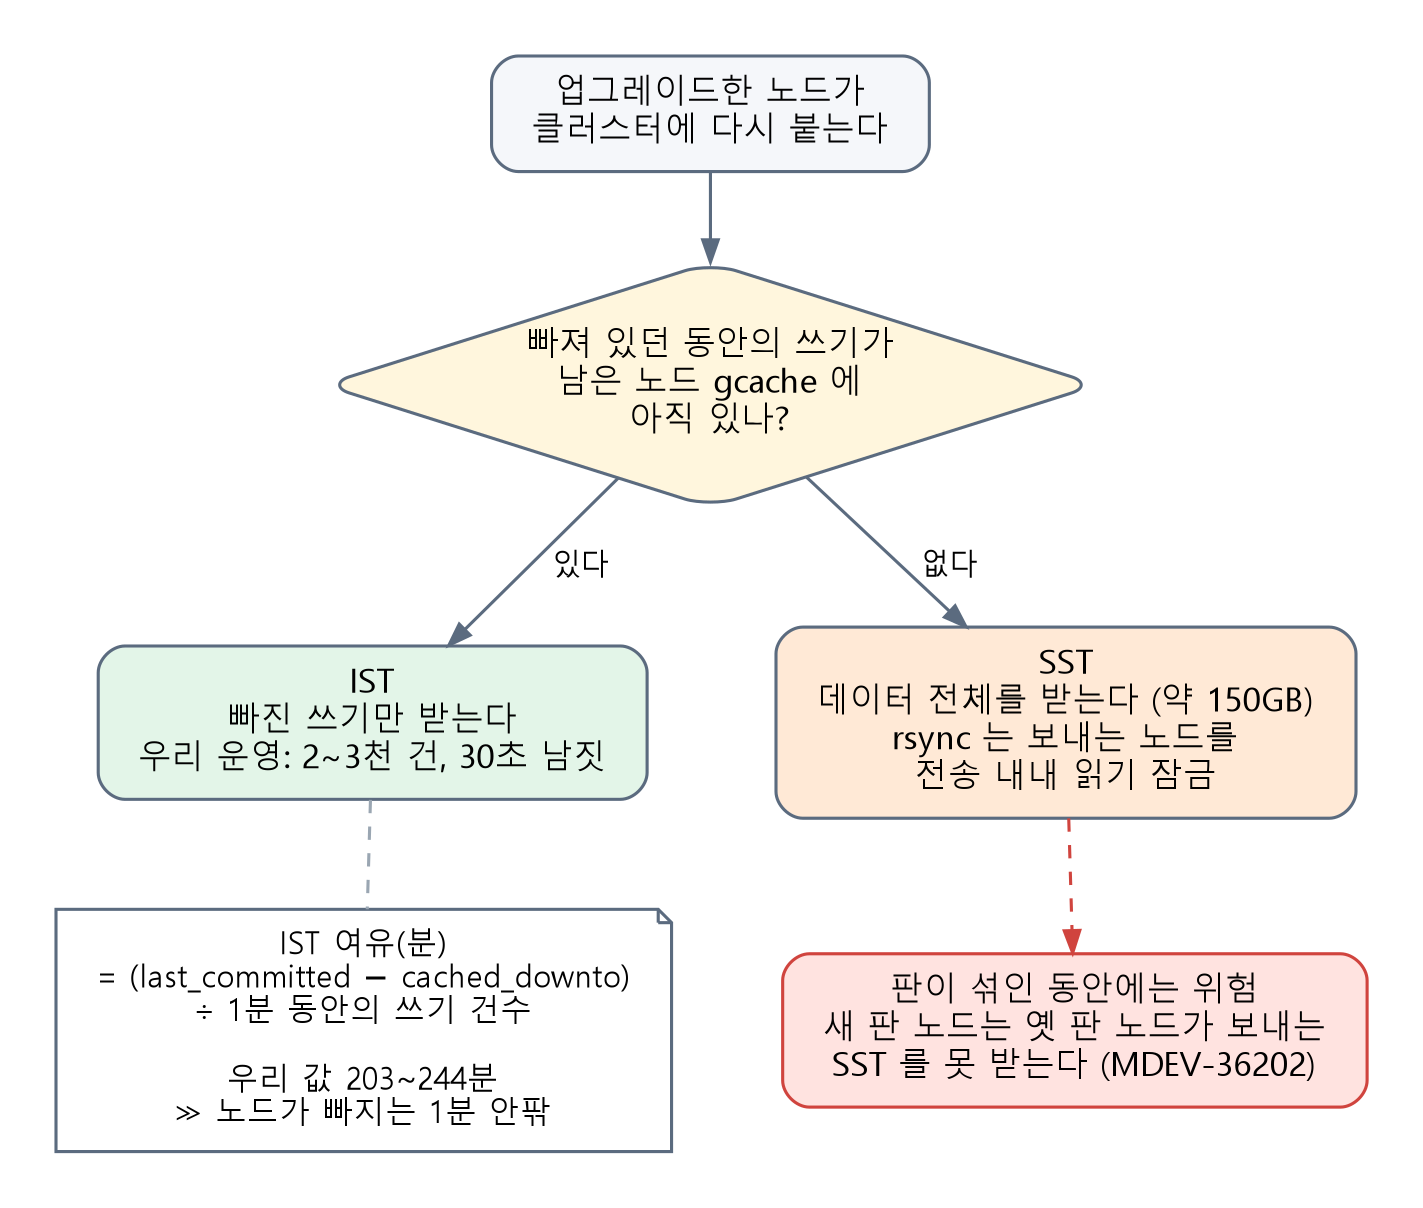
노드 하나를 멈췄다가 새 판으로 다시 켜면, 그 노드는 빠져 있던 동안의 쓰기를 따라잡아야 한다.
- IST: 빠진 쓰기가 남은 노드의 gcache 에 아직 있으면 그것만 받는다. 우리 운영에서는 2~3천 건, 30초 남짓이었다
- SST: gcache 를 넘었으면 데이터 전체(약 150GB) 를 받는다. rsync SST 는 보내는 노드(donor) 를 전송 내내 읽기 잠금으로 묶는다
- 판이 섞인 동안의 SST 는 위험하다. 새 판 joiner 는 옛 판 donor 가 보내는 SST 를 받지 못한다 (MDEV-36202,
InnoDB: Upgrade after a crash is not supported). 리허설에서 일부러 gcache 를 넘겨 보니 그 노드만 죽고 남은 두 노드는 멀쩡했다. 그 노드를 옛 판으로 내려 켜면 전체 SST 로 다시 붙었다
그래서 노드를 멈추기 전에 IST 여유를 잰다. 노드마다 60초 간격으로 두 번 읽는다.
SELECT VARIABLE_NAME, VARIABLE_VALUE
  FROM information_schema.GLOBAL_STATUS
 WHERE VARIABLE_NAME IN ('WSREP_LAST_COMMITTED', 'WSREP_LOCAL_CACHED_DOWNTO');
여유(분) = (last_committed − cached_downto) ÷ 1분 동안 늘어난 last_committed
우리 값은 세 번 모두 203~244분이었고, 노드가 빠져 있는 시간은 1분 안팎이었다. 여유가 1시간 미만이면 미루기로 정해 두었다.
donor 도 정해 둔다. 60-galera.cnf 에 wsrep_sst_donor 한 줄을 넣는다.
- 첫 노드 db3 는 쓰기 노드가 아닌 db2 에서 받는다 —
"node2,". rsync SST 가 donor 를 잠그기 때문이다 - db2·db1 은 이미 올라간 db3 에서 받는다 —
"node3,". IST 가 안 돼 SST 로 넘어가도 같은 판끼리라 받을 수 있다 - 끝의 쉼표는 “지정한 노드가 못 주면 다른 노드도 된다” 는 뜻이다
단, 큰 판이 섞여 있는 동안(특히 10.6 → 10.11)에는 끝 쉼표가 위험하다. 지정한 노드가 못 주면 옛 판 노드(쓰기 노드일 수도 있다)에서 SST 를 받으려 하는데, 새 판 joiner 는 그것을 받지 못하고(MDEV-36202) rsync SST 는 그동안 donor 를 잠근다. 섞인 동안에는 쉼표를 빼 같은 판 donor 로 못 박는 편이 안전하다. 우리는 쉼표를 둔 채로 했고 세 차수 모두 IST 로 붙어 이 길을 타지 않았다.
하나 더 — MDEV-28233 부터는 SST 암호화를 설정해 두고 실제로 할 수 없으면 평문으로 보내지 않고 SST 를 멈춘다. MariaDB 패키지는 stunnel 을 의존성으로 끌어오지 않으니 미리 깔려 있는지 본다.
5. 도커 리허설에서 미리 본 함정
운영에서는 읽기만 하고, 같은 우분투 22.04 · 같은 패키지 · 같은 설정(TDE·TLS 포함) 으로 도커에 세 노드를 세워 세 차수를 끝까지 돌렸다. 무결성 검사는 10번 모두 합격했고, 끊김은 차수마다 정확히 두 번이었다. 다음은 리허설이 아니었으면 운영에서 처음 만났을 것들이다.
10.11 설치는 서버를 켜지 않는다
1차(10.6.28) 와 3차(11.4.13) 는 설치 스크립트가 MariaDB 를 켠다. 2차(10.11.19) 는 켜지 않는다. mariadb-server-10.6 이 지워질 때 그 postrm 이 유닛을 mask 하고, 새 패키지의 postinst 는 멈춰 둔 서버를 그대로 둔다. 그래서 설치 뒤에 꺼져 있으면 켠다.
systemctl is-active --quiet mariadb || { systemctl daemon-reload; systemctl start mariadb; }
mariadb-upgrade 는 노드마다 돌린다
mariadb-upgrade 는 세션에 SET SQL_LOG_BIN=0, WSREP_ON=OFF 를 건다. 다른 노드로 복제되지 않으니 노드마다 한 번씩 돌려야 한다. 리허설에서 쓰기를 멈추고 여섯 번 돌려 보니 세 노드의 wsrep_last_committed 가 그대로였다 — 옛 판 노드가 섞여 있어도 해가 없다.
/db 안에 백업 사본을 두면 안 된다
데이터 디렉터리가 그 디스크의 맨 위라, 거기 둔 디렉터리는 이름이 무엇이든 MariaDB 가 DB 로 본다. 리허설에서 /db/.db-bak 이 #mysql50#.db-bak 으로 보였다.
mariadb-upgrade가Incorrect database name '#mysql50#.db-bak'으로 실패한다- rsync SST 가 그 사본까지 함께 보낸다 — SST 가 두 배가 되고 받는 쪽 디스크가 찬다
OS 디스크에는 150GB 를 둘 자리가 없었다. 그래서 백업은 하이퍼바이저의 VM 스냅샷 으로 했다 (8절).
CREATE_OPTIONS 의 표기가 바뀐다
10.6.23 은 `ENCRYPTED`=YES, 10.6.28 부터는 `ENCRYPTED`='YES' 다. “아직 암호화 안 된 테이블” 을 고르는 우리 스크립트가 NOT LIKE 로 옛 표기를 찾고 있어서, 10.6.28 에서는 이미 암호화된 테이블을 전부 “안 된 것” 으로 골랐다. 그대로 실행했다면 큰 테이블을 다시 ALTER 했을 것이다. 두 표기를 다 받게 고쳤다.
-- 암호화된 테이블
WHERE CREATE_OPTIONS RLIKE '`ENCRYPTED`=.?YES'
11.4 클라이언트는 서버 인증서를 기본으로 검증한다
3차 도중에는 먼저 올라간 노드의 11.4 클라이언트로 아직 10.11 인 노드에 붙을 일이 생긴다. 3차 앞에 세 노드에 클라이언트용 CA 설정을 한 줄 둔다.
# /etc/mysql/mariadb.conf.d/63-client-tls.cnf
[client-mariadb]
ssl-ca = <DB 전용 CA 파일>
패키지 파일 50-client.cnf 는 고치지 않는다. 고치면 다음 업그레이드에서 conffile 질문이 생긴다.
자동 업데이트가 MariaDB 를 고르지 않게
저장소를 MariaDB 공식 저장소로 바꾸면 unattended-upgrades 가 새 판을 끌어올 수 있다. Package-Blacklist 에 mariadb-·libmariadb·galera 를 넣고, needrestart 가 MariaDB 를 저절로 재시작하지 않게 막은 뒤 확인한다.
unattended-upgrade --dry-run -d 2>&1 | grep -iE 'blacklist|mariadb|galera'
그 밖에
- 없어진 옵션은 기동을 막지 않는다. 10.11·11.4 모두 “was removed. It does nothing now” 경고만 낸다. 그래도 1차에서 네 줄(
innodb_buffer_pool_instances·innodb_log_files_in_group·innodb_thread_concurrency·innodb-defragment) 을 지웠다 /db/lost+found가 있으면mariadb-upgrade가lost@002bfound라는 빈 DB 를 만든다. 생겼으면 업그레이드 전에 치운다
6. 노드 한 대 절차
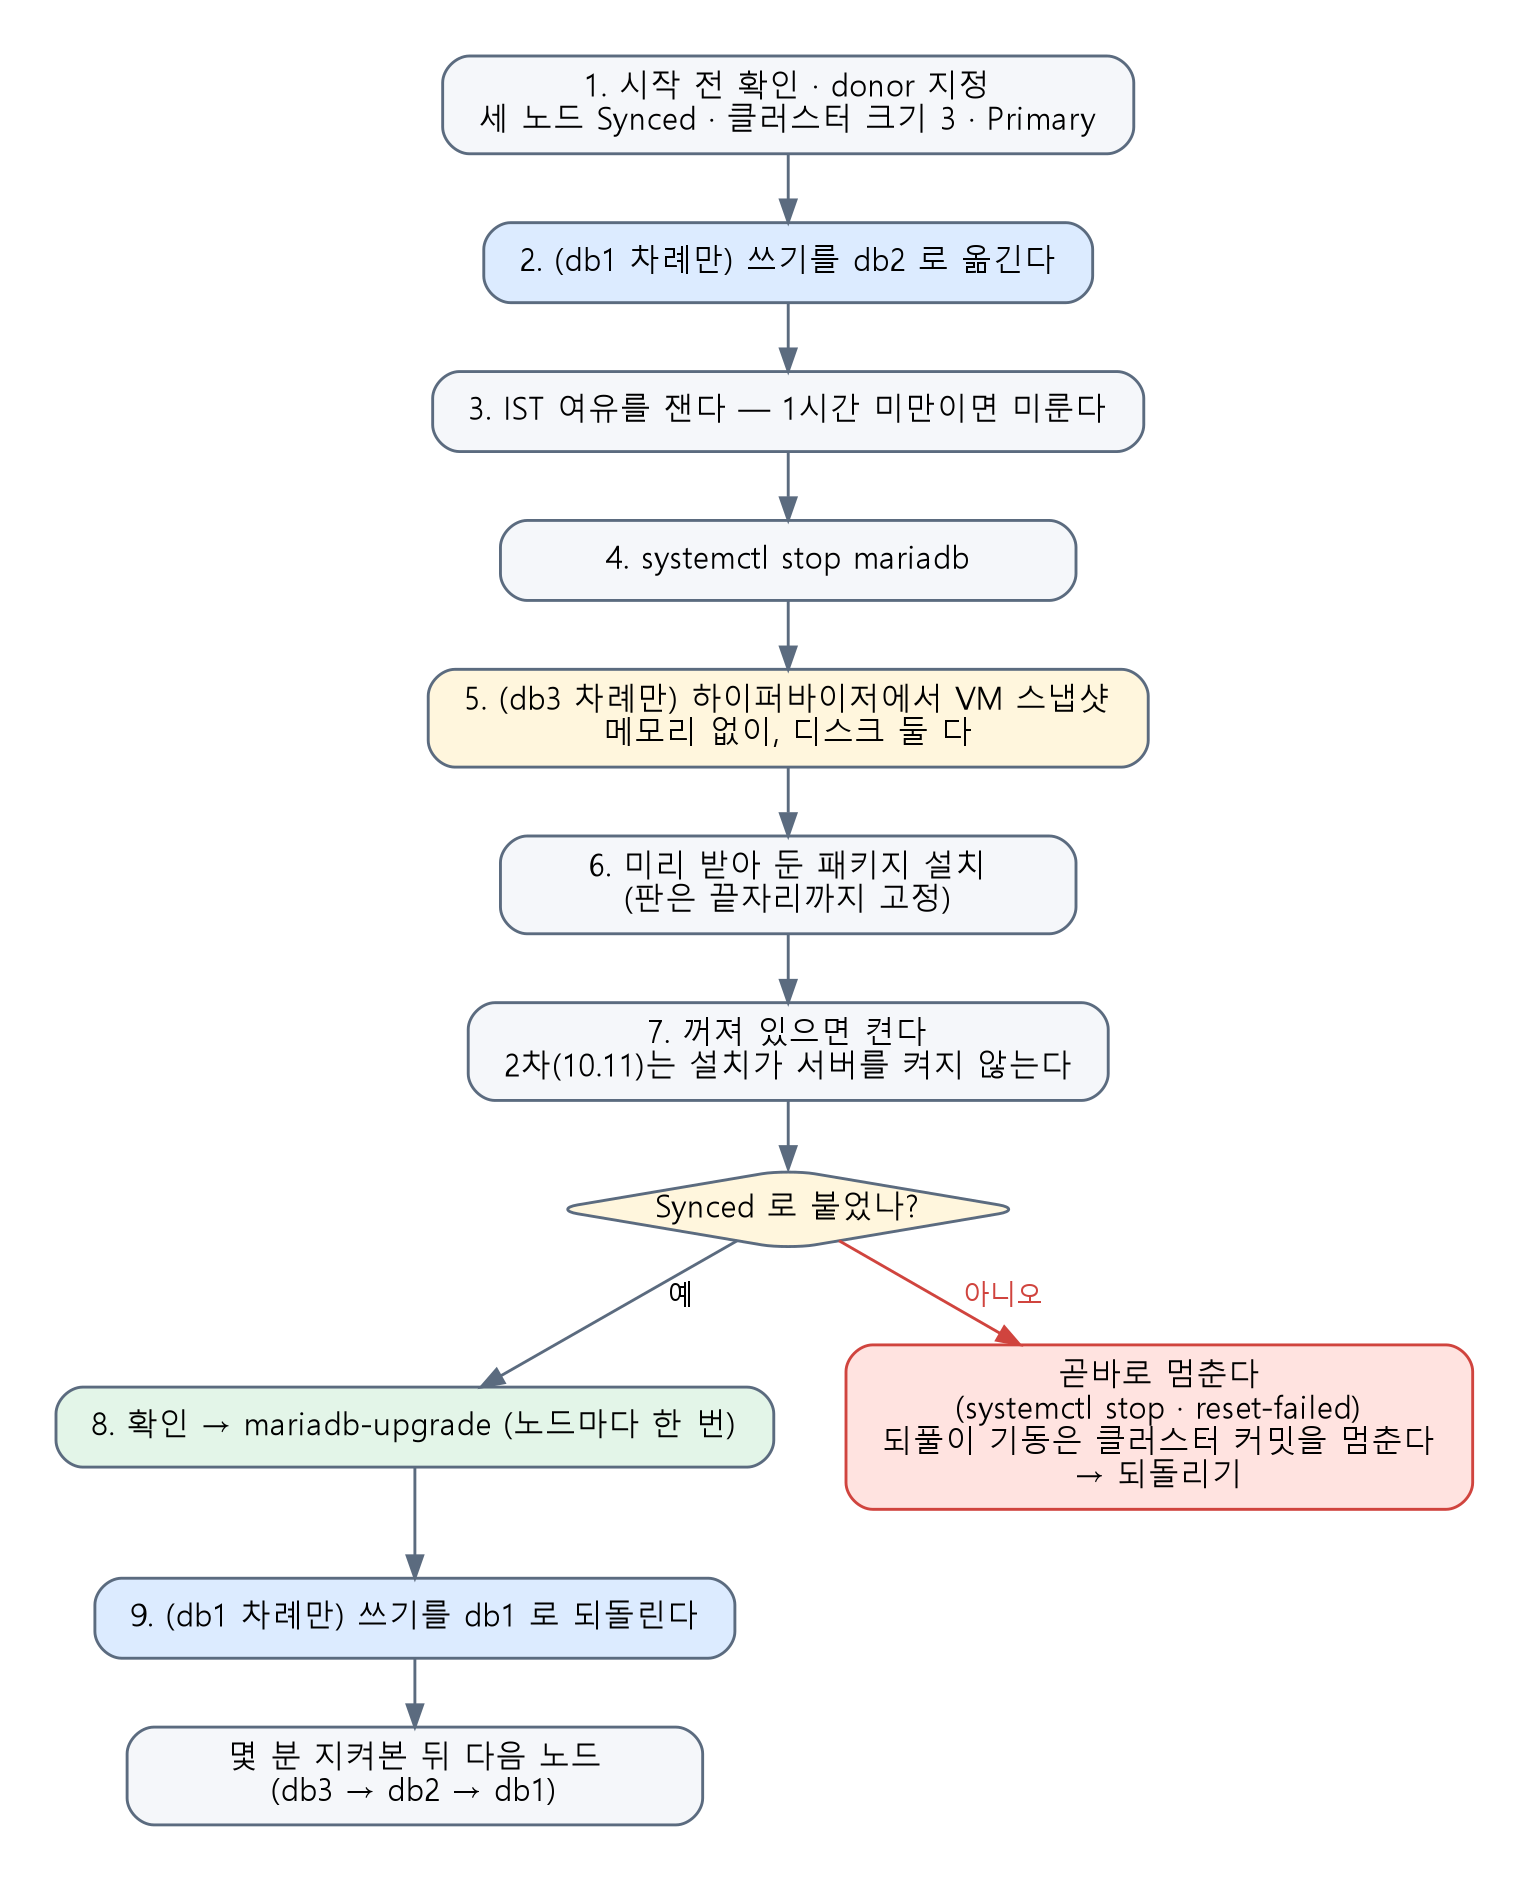
순서는 차수마다 db3 → db2 → db1 이다. 쓰기 노드 db1 을 맨 마지막에 둔다.
준비 (재시작 없음) — 차수 전날까지 세 노드에 해 둔다.
# /etc/mysql 을 통째로 백업 (키·인증서·설정이 다 여기 있다. 경로는 예시)
tar czf /var/backups/etc-mysql-$(date +%F).tgz -C / etc/mysql

# MariaDB 저장소 키링 — sha256 을 공식 값과 대조한다
install -d -m 0755 /etc/apt/keyrings
curl -fsSL -o /etc/apt/keyrings/mariadb-keyring.gpg https://supplychain.mariadb.com/mariadb-keyring-2025.gpg
sha256sum /etc/apt/keyrings/mariadb-keyring.gpg

# 이번 차수 판으로 저장소 파일을 직접 놓는다 — 판은 끝자리까지
cat > /etc/apt/sources.list.d/mariadb.sources <<'EOS'
Types: deb
URIs: https://dlm.mariadb.com/repo/mariadb-server/10.11.19/repo/ubuntu
Suites: jammy
Components: main
Architectures: amd64
Signed-By: /etc/apt/keyrings/mariadb-keyring.gpg
EOS
# 이 저장소가 우분투 패키지보다 앞서게 핀을 건다
printf 'Package: *\nPin: origin dlm.mariadb.com\nPin-Priority: 1000\n' > /etc/apt/preferences.d/mariadb-enterprise.pref
apt-get update
apt-get -d -y install mariadb-server mariadb-client mariadb-backup galera-4 libmariadb3 mysql-common   # 받아만 둔다
mariadb_repo_setup 스크립트는 수시로 바뀐다. 운영 날 받은 스크립트가 리허설 때와 다른 파일을 만들 수 있어서, 스크립트가 만드는 파일을 직접 놓았다. 키링 파일은 sha256 을 공식 값과 대조한다.
아래 명령은 노드·로드밸런서에서 root 로 친다.
노드 한 대
- 시작 전 확인 · 이 노드 차례의
wsrep_sst_donor지정 (4절) — 세 노드Synced,wsrep_cluster_size=3,Primary. 로드밸런서 두 대에서 db1~3 이 모두 UP - (db1 차례만) 쓰기를 db2 로 — 7절
- IST 여유를 잰다 — 1시간 미만이면 미룬다
- 멈춘다 —
systemctl stop mariadb. 남은 두 노드가Primary·Synced인지 본다 - (db3 차례만) VM 스냅샷 — 8절
- 설치
DEBIAN_FRONTEND=noninteractive NEEDRESTART_MODE=l apt-get install -y \

     -o Dpkg::Options::=--force-confdef -o Dpkg::Options::=--force-confold \

     mariadb-server mariadb-client mariadb-backup galera-4 libmariadb3 mysql-common
- 꺼져 있으면 켠다 — 2차만 해당 (5절)
systemctl is-active --quiet mariadb || { systemctl daemon-reload; systemctl start mariadb; }
Synced를 확인한 뒤mariadb-upgrade
cd /tmp && sudo -u mysql mariadb-upgrade --user=mysql --skip-write-binlog
우분투 기본 설치는 root 가 unix_socket 이라 sudo mariadb-upgrade --skip-write-binlog 로 된다. 우리 노드는 root 로그인이 막혀 있어 설치 때 만들어지는 mysql@localhost(unix_socket) 로 돌렸다. cd /tmp 는 mysql 사용자가 지금 디렉터리(/root)를 못 읽어 나는 오류를 피하려는 것이다
- (db1 차례만) 쓰기를 db1 로 되돌린다
- 몇 분 지켜보고 다음 노드. 차수의 첫 노드 db3 는 30분 지켜봤다
붙지 못하면 곧바로 멈춘다. systemctl stop mariadb; systemctl reset-failed mariadb. 리허설에서 붙지 못한 노드를 그냥 두었더니 systemd 가 5분 동안 31번 다시 띄웠고, 붙으려 할 때마다 남은 두 노드가 그 노드를 넣었다 뺐다 하며 커밋을 세웠다 — 1초 넘게 걸린 쓰기가 41건, 10초 시간 초과가 5건이었다.
7. 쓰기 노드 옮기기
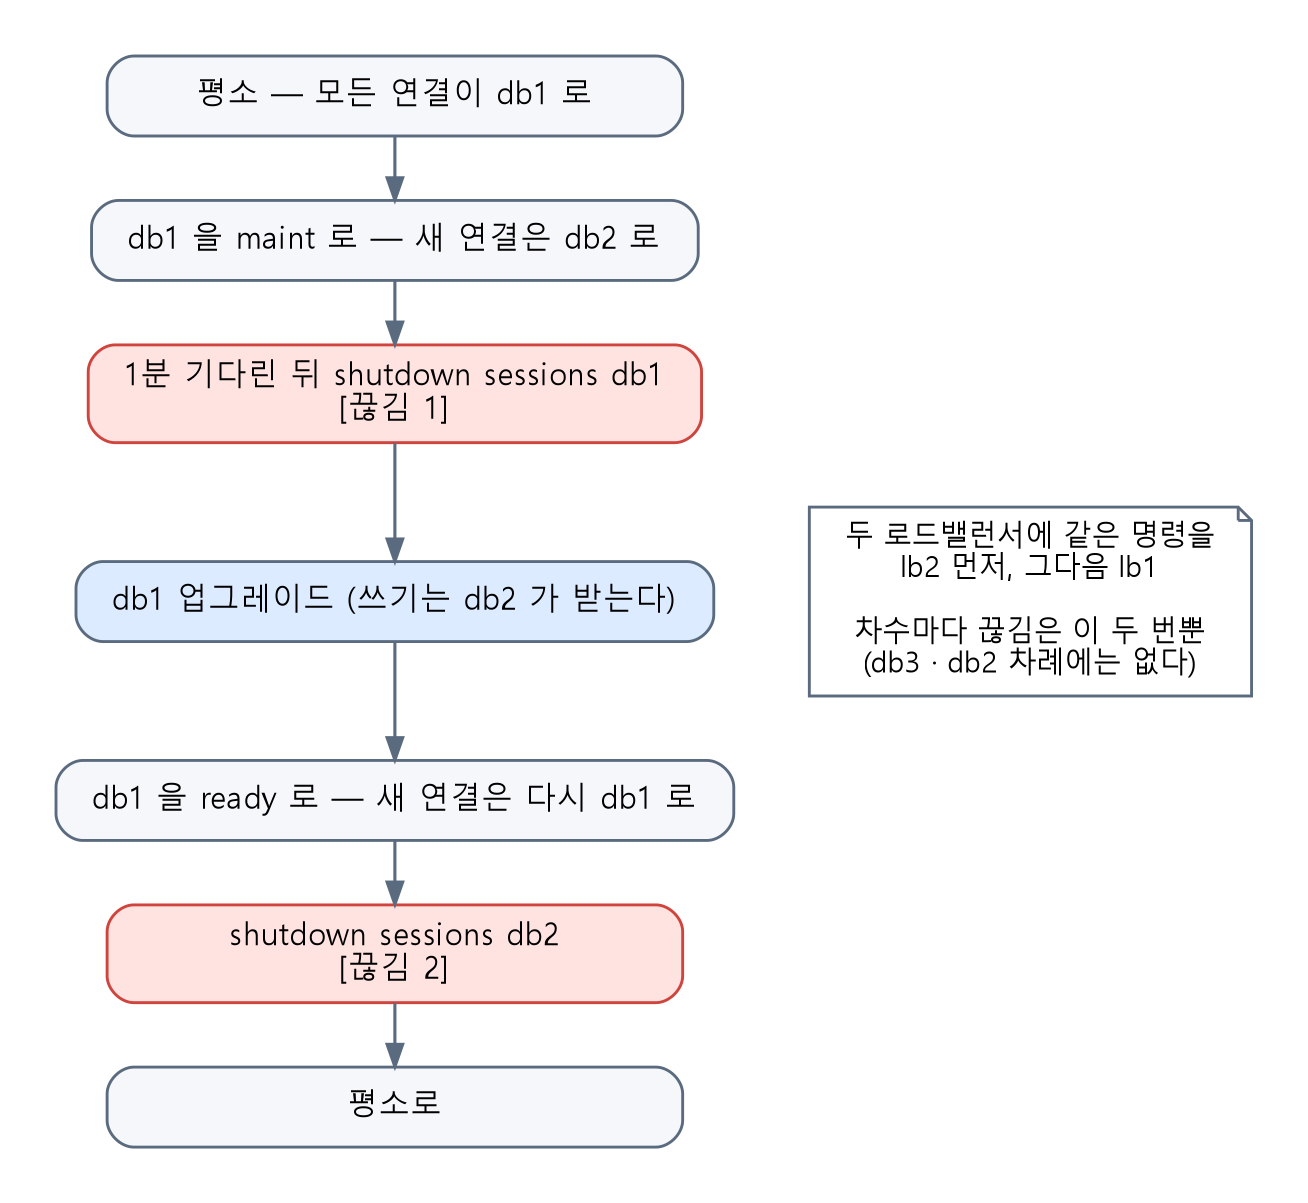
db3·db2 는 연결이 없는 대기 노드라 멈춰도 끊기는 연결이 없다. db1 차례만 HAProxy 런타임 API 로 쓰기를 옮긴다. 두 로드밸런서에 같은 명령을, 대기 쪽 lb2 먼저 보낸다.
# 앞 — db1 을 빼고 남은 세션을 끊는다
echo "set server <백엔드>/db1 state maint"   | nc -U /run/haproxy/admin.sock
# 1분쯤 기다리며 db1 의 Threads_connected 가 0 에 가까운지 본다
echo "shutdown sessions server <백엔드>/db1" | nc -U /run/haproxy/admin.sock     # 끊김 1

# 뒤 — db1 이 Synced 로 돌아오고 mariadb-upgrade 까지 끝나면
echo "set server <백엔드>/db1 state ready"   | nc -U /run/haproxy/admin.sock
echo "shutdown sessions server <백엔드>/db2" | nc -U /run/haproxy/admin.sock     # 끊김 2
- 끊김은 차수마다 이 두 번뿐이다. 앱이 다시 붙으면 끝난다
maint로 돌려도 풀에 오래 붙어 있는 연결은 남는다. 3차에서는 1분 반이 지나도 10개가 남아 있었다. 기다리지 말고shutdown sessions로 끊는 것이 낫다- 로드밸런서를 거치지 않는 연결도 있었다. 1차 때 db1 에 바로 붙어 있던 연결 두 개가 db1 을 멈출 때 끊겼다. 미리 세어 보면 누가 바로 붙는지 알 수 있다
- 읽기를 여러 노드에 나누는 구성이면 노드가
Synced가 되는 순간 상태 검사를 통과해 읽기가 들어온다.mariadb-upgrade가 끝날 때까지 그 노드를 로드밸런서에서 maint 로 두는 편이 낫다
8. 스냅샷은 차수 중간에만 쓸모 있다
- 차수마다 db3 차례에 MariaDB 를 멈춘 뒤, 설치 전에 하이퍼바이저에서 db3 VM 스냅샷을 찍었다. 메모리 없이 디스크 둘(OS·
/db) 만. MariaDB 가 멈춰 있어 디스크가 일관된다 - 그 차수 도중에 문제가 생기면 db3 를 스냅샷으로 되돌려 켠다. 다른 두 노드가 모든 쓰기를 갖고 있으니 IST(또는 같은 판끼리 SST) 로 따라잡는다 — 잃는 것이 없다
- 차수가 끝나면 그 스냅샷은 쓸 데가 없다. 한 노드만 옛 판으로 되돌릴 수 없고(리허설:
Group requested gcs_proto_ver: 6, max supported by this node: 2), 그 스냅샷으로 클러스터를 다시 세우면 스냅샷 뒤의 쓰기를 모두 잃는다. 남겨 두면 씬 풀만 차고 키가 든 디스크 사본이 남는다. 그래서 차수가 끝나면 바로 지웠다 - 패키지만 옛 판으로 내리는 되돌리기는 안 된다. 10.8 에서 redo 로그 형식이 바뀌었고 11.0 에서 change buffer 가 없어졌다 — 새 판이 한 번 연
/db는 옛 판이 열지 못한다
9. 결과
| 차수 | 날짜 | 걸린 시간 | 판 | 노드가 빠진 시간 (db3 / db2 / db1) | IST 여유 | 끊김 |
|---|---|---|---|---|---|---|
| 1차 | 2026-10-01 | 약 12분 | 10.6.23 → 10.6.28 | 48초 / 48초 / 31초 | 240분 | 2번 |
| 2차 | 2026-10-02 | 약 42분 (첫 노드 뒤 30분 지켜본 것 포함) | → 10.11.19 | 48초 / 33초 / 35초 | 244분 | 2번 |
| 3차 | 2026-10-06 | 약 38분 (같음) | → 11.4.13 | 29초 / 36초 / 34초 | 203분 | 2번 |
- 세 차수 모두 백엔드 DB 오류 0건, 종단 시험(e2e) 네 가지가 앞뒤로 실패 0건
- 3차 IST 는 노드마다 2,167~2,553건이었고,
mariadb-upgrade는 41·58·91초 걸렸다 (그동안 노드는 이미 클러스터에서 돈다) - 3차 뒤 세 노드의 우리 서비스 테이블 수십 개의 체크섬이 같았고, 저장 암호화(
file_key_managementACTIVE) 와 TLS 가 그대로였다 - 지금은 세 노드 모두 MariaDB 11.4.13 · Galera 26.4.27 이다
10. 배운 것
- 리허설은 운영과 같은 패키지 · 같은 설정이어야 한다. 5절의 함정은 대부분 “판이 바뀌면서 조용히 달라진 것” 이었다. 도커로 세 차수를 끝까지 돌려 본 덕에 운영에서는 놀랄 일이 없었다
- root 로그인이 막혀 있으면
mariadb-upgrade에--user=mysql을 붙인다. 빼면 root 로 붙어 1045 로 실패한다. 우리 노드는 OS 의mysql사용자가 unix_socket 으로 붙는 관리자 계정을 갖고 있었다 - 기록 파일의 소유자를 본다. 1차 때
/db/mysql_upgrade_info가 예전에 root 로 만들어져 있어errno: 13으로 실패했다.chown mysql:mysql로 고쳤다. 11.4 는mariadb_upgrade_info를 새로 만드는데mysql:mysql로 생겨 다시 나지 않았다 - 재시작 때
debian-start의 root 1045 는 무해하다. 기동도 apt 도 실패시키지 않는다 - 마지막 차수 전에 개발 DB 를 먼저 올렸다. 컨테이너 이미지만 10.6.22 → 11.4.13 으로 바꾸고(볼륨은 그대로) 개발 쪽 종단 시험을 돌렸다. 되돌릴 수 있게 볼륨은 깨끗이 멈춘 뒤 따로 떠 두었다
- 업무 시간에 해도 됐다. 끊김이 차수마다 두 번뿐이라 한가한 시간을 기다리지 않았다
11. 다음
- OS 24.04 전환 — MariaDB 는 OS 표준 지원이 끝나면 빌드를 멈춘다. jammy 용 11.4 는 2027-06 무렵까지다. noble 에는 10.6 이 없지만 11.4 는 있으니, 클러스터를 먼저 11.4 로 올린 것이 다음 단계의 준비이기도 하다
- mariabackup SST 검토 — rsync SST 는 donor 를 전송 내내 묶는다. mariabackup 은 끝에 잠깐만 묶는다. 리허설에서는 11.4 에서 TLS·암호화된 테이블까지 넘어갔다
- 하이퍼바이저 판 올리기와 오래된 노드를 새 서버로 바꾼 이야기는 다음 글에서 다룬다